
숫자로 보는 10억 엔터티 데모
- 포럼 샤드 1,128개, 개인 샤드 1개, 패브릭 프로세서 3개
- 각 포럼 샤드에는 9억 개의 relationships와 1억 8,200만 개의 nodes가 포함되어 있어요. 개인 샤드는 30억 명의 사람과 160억 개의 relationships를 포함하고요.
- 전체적으로 전체 데이터세트는 280TB이고 relationships는 1조 개나 돼요!
- 시작부터 최종 결과까지 3주나 걸렸어요.
- 전체 규모로 실행하려면 시간당 약 $400의 비용이 들어요.

"100개의 머신은 멋지지 않아요. 멋진 게 뭔지 아세요? 1조 개의 relationships죠."
누군가가 실제로 이런 정확한 말을 했다고 말하는 건 아니지만, 우리 모두가 그렇게 생각했다고 확신해요. 한 달 전, 우리는 지금까지 존재했던 가장 큰 Graph Database를 구축하기로 결정했거든요.
우리는 3주 만에 해냈답니다!
동기 부여
Fabric을 도입했을 때 우리는 다음에서 제시된 개념 증명 벤치마크도 만들었어요. 포스뎀. 1TB 데이터베이스의 경우 처리량과 대기 시간은 분산된 샤드 수에 따라 선형적으로 향상되는 것으로 나타났어요. 더 많은 샤드, 더 많은 성능! 결과는 좋아 보였고 Graph Database 확장에 대한 접근 방식을 매우 잘 이해하고 있음을 확인시켜 줬죠. Fabric의 개발은 Neo4j의 필수 부분으로 만들기 위해 계속되었어요. 새로운 기술이 개발 및 개선되었으며(서버측 라우팅이 좋은 예죠) Fabric이 아닌 설정에도 유용하게 사용되었답니다.
하지만 FOSDEM의 1TB 데이터세트는 항상 우리를 괴롭혔어요. 적어도 Neo4j의 경우 1TB는 크지 않거든요. 우리는 일상적으로 10TB 이상의 프로덕션 설정을 가지고 있고 상당히 큰 시스템에서 실행되지만 Neo4j는 꽤 잘 확장돼요. 이에 대한 솔루션은 실제로 필요하지 않았어요. 우리에게는 솔루션이 필요했어요. 큰 데이터베이스 말이죠. 그래서 Fabric을 만들었지만 아직까지 한계를 발견하지 못했답니다.
그리고 그 규모는 얼마나 될까요? 1년 전 우리는 40대의 머신으로 구성된 클러스터를 구축했는데 꽤 잘 작동했어요. 100대를 목표로 하는 것은 그다지 어려운 일이 아닌 것 같았죠. 아마도 수십억 개의 nodes일까요? 수십억 개의 nodes는 몇 TB의 데이터와 같아요. 또한 그래프 스키마의 풍부함은 nodes 자체가 아닌 nodes 간의 relationships에서 비롯돼요. 기억하세요: 우리는 단순히 기분을 좋게 하거나 보기 좋게 만드는 것이 아니라 Neo4j를 얼마나 멀리 추진할 수 있는지 보려고 노력하고 있는 거예요.
때때로 같은 논의가 오갔고, 우리가 현실적인 목표를 세울 수 있는 피뢰침과 같은 기회를 찾고 있다는 것이 분명해졌어요.
알고 보니 그 기회는 노드 2021이었어요.
주의를 요하는 규모
우리는 규모에 대해 이야기할 때 무엇을 의미하는지 세상에 보여줘야 한다고 결정했어요. 아니다 just Neo4j는 수평적으로 확장할 때 성능을 유지하거나 향상시킬 수 있지만 성능을 유지하면서 얼마나 멀리 갈 수 있는지 보여주기 위한 것이죠.
우리는 더 큰 숫자가 필요할 거예요. 주의가 필요한 것 말이죠. 수백 대의 머신이나 수십억 개의 nodes가 아니고요.
수조.
1000억 개의 relationships가 그걸 해낼 거예요, 그렇죠?
1조 개의 relationships가 있는 데이터베이스를 어디에서 찾을 수 있을까요? 생산 설정을 사용하면 물류 문제가 발생할 수 있어요. 데이터를 난독화하여 대중이 볼 수 있도록 하는 것은 말할 것도 없고 데이터 전송 자체도 복잡할 거예요. 우리는 알려진 모델에서 스스로 이를 생성해야 했어요. 그리고 우리는 데이터 모델부터 시작해야 한다는 것을 알았죠. 이를 통해 기계의 수와 크기, 실행할 queries, 생성할 테스트를 알 수 있었기 때문이에요. 즉, 데이터 모델부터 시작하여 필요한 노력을 파악하는 거죠.
LDBC는 좋은 후보죠. 사람, 포럼, 게시물을 포함하는 소셜 네트워크인데, 이해하고 설명하기 쉬워서 저희도 아주 익숙해요. 저희는 지구상에서 가장 큰 소셜 네트워크를 뛰어넘는 30억 명의 사람들을 기준으로 정했어요. 소셜 연결 정도는 개인 샤드가 850GB, 모든 포럼 샤드가 각각 약 9억 개의 관계를 포함하는 250GB가 되도록 선택되었어요. 1조 개의 관계라는 목표를 달성하려면 각각 자체 머신인 총 1,110개의 포럼 샤드가 필요하죠.
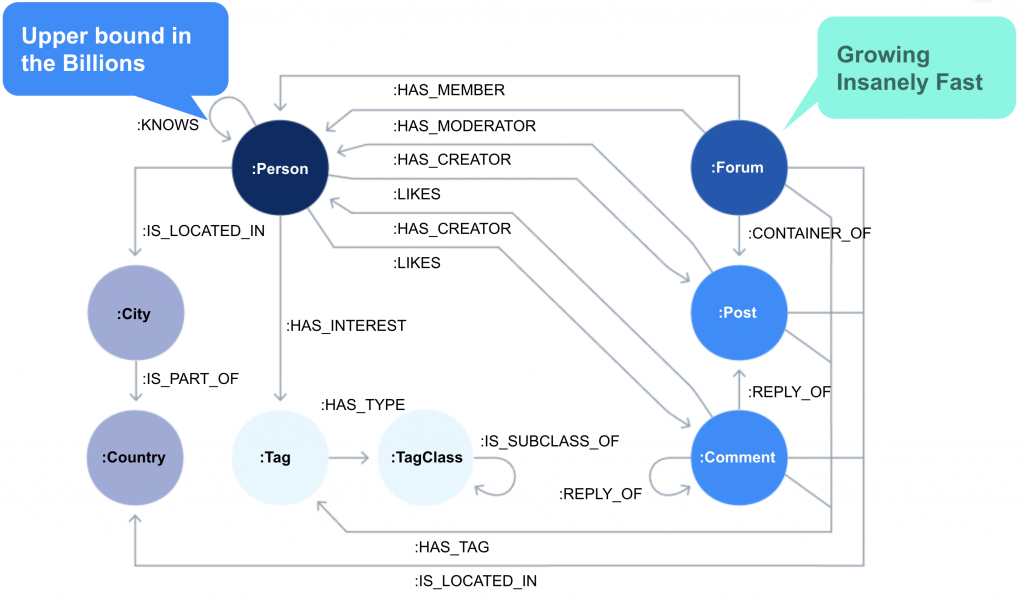
이건 1,110개의 포럼 샤드와 중복성을 위한 몇 개의 샤드이고, 각 샤드에는 스토어가 생성되어야 해요. 저희는 3개를 원했는데 Fabric 프록시 10, 100 및 모든 샤드에 연결해서 데이터 크기가 증가함에 따라 시스템이 어떻게 확장되는지 확인하려고 했죠. 시간이 촉박해지면서 이 모든 머신을 조율할 계획이 필요했어요.
위험을 관리하는 게 전부였어요. 문제가 발생하면 스토어 생성 중이거나 네트워크에 심각한 결함이 있을 거라고 예상했죠. 결과적으로 저희는 절반만 맞았어요.
현실로 만들기
복잡성의 주요 원인은 두 곳에서 나왔어요. 그 중 하나는 샤드를 호스팅할 수많은 머신이었고, 다른 하나는 샤드 데이터를 생성하는 것이었어요. 저희는 이 작업이 병렬로 수행되어야 하고 따라서 많은 시스템을 조정해야 한다는 것을 알고 있었죠.
저희에게는 2단계 접근 방식이 필요했어요. 첫 번째 단계는 전체 규모의 스토어이지만 소수의 Neo4j 프로세스였죠. 이를 통해 병렬 스토어 생성, 생성기, 버킷에서 샤드까지 스토어 설치를 테스트하고 대기 시간 측정 클라이언트의 MVP도 테스트할 수 있었어요. 이걸 통해 저희의 오케스트레이션 도구(나중에 제공될 예정)에 스트레스를 주지 않고 개념 증명을 위해 모든 것을 올바르게 연결하는 데 집중할 수 있었죠. 모든 일이 꽤 잘 진행되었고 저희는 모든 부분을 제자리에 두었어요. 모든 것이 함께 작동하는 것처럼 보였고 이제 숨을 참고 두 번째 단계인 전체 크기로 이동할 수 있었죠.
2주 남았을 때 저희는 2단계로 넘어갔어요. 모든 노력을 다하고 충격에 대비했죠.
가장 먼저 발생한 문제는 약 800대의 시스템에서 AWS 인스턴스 프로비저닝이 예기치 않게 실패하기 시작했다는 거였어요. 일부 조사 작업을 통해 AWS 계정에 더 이상 머신을 생성할 수 없는 vCore 제한이 있다는 사실을 발견했죠. AWS Support는 이를 즉시 해제했고 저희는 계속해서 인스턴스를 생성했지만 더 심각한 제한에 직면했어요.
"현재 'gp2' 볼륨을 지원하는 영역에는 x1e.4xlarge 용량이 충분하지 않습니다. 우리 시스템은 추가 용량을 프로비저닝하기 위해 노력할 것입니다."
흠. 아마존의 용량이 부족한 것 같아요. 이로 인해 저희에게는 두 가지 옵션이 남았어요. 여러 가용 영역을 선택하거나 더 작은 인스턴스 유형을 선택하는 거였죠. 다중 AZ에는 더 많은 복잡성과 알려지지 않은 사항이 있다고 판단해서 지금은 더 작은 인스턴스를 수행하고 성능이 문제인 경우 나중에 처리하기로 결정했어요. 전체 인스턴스 수를 확보하는 것이 가장 중요한 목표였으니까요.
더 작은 인스턴스를 사용하는 것이 성공했고, 다음날 저희는 전체 샤드를 가동해서 실행할 수 있었어요. 지연 시간 측정 데모 앱이 거의 준비되었으므로 저희는 현재 위치를 확인하기 위해 몇 가지 측정을 수행하기로 결정했죠.
하지만 그게 말처럼 쉽지는 않을 거예요.
1,129개의 샤드를 모두 가리키는 전체 Fabric 프록시가 시간 초과되었어요. Neo4j 로그 파일에는 관련 오류 메시지가 없었고 시간 초과만 있었죠. GC 일시 중지나 잘못된 방화벽 구성도 아니었어요. 일반적인 용의자 중 누구도 비난을 받지 않았죠. 각 개별 샤드는 정상적으로 응답했으며 Fabric 프록시도 아무런 문제를 나타내지 않았어요. 문제가 DNS 쿼리 제한이라는 사실을 알아내기까지는 저녁 시간의 조사 작업이 필요했어요. AWS 설명서에서 다음과 같이 지적하죠.
"Amazon에서 제공하는 DNS 서버는 ENI(탄력적 네트워크 인터페이스)당 초당 1024개의 패킷 제한을 적용합니다. Amazon에서 제공하는 DNS 서버는 이 제한을 초과하는 모든 트래픽을 거부합니다."
예. 그렇게 해야 해요. Fabric 구성은 샤드에 DNS 이름을 사용했기 때문에 제출한 모든 쿼리에서 해당 제한에 즉시 도달했죠. 솔루션은 매우 간단했어요. DNS 항목을 Fabric 인스턴스에 정적으로 만들고 더 이상 DNS에 의존하지 않기만 하면 됐죠.
그리고 그것이 저희가 극복해야 할 마지막 한계였어요. 초기 지연 시간 수치는 매우 좋아 보였고 더 큰 인스턴스 유형으로 이동할 이유가 없다고 판단해서 비용을 합리적으로 유지하는 데에도 도움이 되었죠. 전반적으로 저희는 버튼 하나만 누르면 3시간 이내에 3개의 Fabric 프록시를 사용하여 280TB의 데이터를 호스팅하는 1129개의 샤드 클러스터를 설정할 수 있는 도구를 구축했어요. 그리고 거기까지 가는 데 16일이 걸렸답니다.
남은 시간에는 구성과 쿼리를 Fine-tuning하고, 대기 시간 측정 앱을 시험해봤어요. 그리고 그래프 자체를 가지고 놀면서, 그렇게 큰 규모의 설정을 다루는 느낌을 직접 경험해봤죠. 이 작업 결과는 NODES 2021 기조 연설에서 확인하거나, trillion-graph repository를 사용해서 직접 시도해볼 수도 있어요.
마무리하며
이건 정말 긴 여정의 첫걸음에 불과해요. 대규모 Graph Database가 어떻게 작동하는지, 네트워크 변형이 노이즈로 집계되는 방식, 그리고 이 데모에서 달성한 수치를 뛰어넘어 시스템을 확장하려면 앞으로 더 많은 연구가 필요하답니다.
- 가장 큰 Graph Database
- Neo4j 패브릭
- 1조 개의 관계
- 조 엔터티
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| Neo4j Text2Cypher (2024) 데이터셋으로 성능 제대로 측정하기 (0) | 2026.09.27 |
|---|---|
| Neo4j Text2Cypher (2024) 데이터셋으로 성능 제대로 측정하기 (0) | 2026.09.27 |
| 9월 9일, AWS에서 Neo4j AuraDB Enterprise 마스터 되기 (0) | 2026.09.27 |
| Neo4j로 대량 삽입, 자동 인덱싱하고 친구 추천까지 한 번에! (0) | 2026.09.26 |
| Batching Like a Pro (0) | 2026.09.26 |