
지금이 이민을 가야 할 시기인 이유apoc.주기적.반복 to 거래 시 { ... }를 호출하세요.

인기 있는 플러그인인 APOC Core는 오랫동안 Cypher의 구멍에 붕대 역할을 해 왔지만, 출시될 때마다 구멍이 점점 작아지고 APOC는 서서히 사라지고 있습니다.
이에 대한 좋은 예는 Cypher의 것입니다.거래 중 {…}을(를) 호출하세요.(CIT). 지난 몇 년 동안 CIT에 기능이 추가되어 CIT와 APOC 간의 차이점이 사라졌습니다.apoc.주기적.반복.
절차apoc.주기적.반복OOM 문제를 방지하고 프로시저 스레딩 기능을 사용하여 속도를 향상시키기 위해 대량으로 데이터를 트랜잭션 방식으로 생성, 업데이트 및 삭제하는 방법으로 사용되었습니다. 이 블로그에서는 모든 원래 사용 사례를 다룰 것입니다.apoc.주기적.반복Cypher에서 동등한 사용 사례를 보여주고 전환해야 하는 이유를 설명합니다.
… 거래 중
전통적으로 쿼리는 하나의 트랜잭션에서 실행되므로 단순한 실수나 OOM 오류 또는 시간 초과와 같은 더 심각한 문제로 인해 쿼리에 오류가 발생한 경우 해당 지점까지 이루어진 모든 변경 사항이 손실되고 롤백됩니다. 하나의 쿼리에서 대량 업데이트를 실행할 때 발생하는 또 다른 문제는 메모리에 저장된 임시 데이터의 양으로 인해 OOM 오류가 발생할 가능성이 높다는 것입니다! 이는 APOC가 도입하여 해결한 오래된 데이터베이스 문제였습니다.apoc.주기적.반복. 이 절차에서는인수를 사용하여 커밋하기 전에 프로시저가 실행해야 하는 행 수를 쿼리 작성자에게 제어할 수 있습니다. 이미 짐작하셨겠지만 이 문제는 이제 Cypher에서도 해결되었습니다.😉
메모리 추적
전환의 주된 이유는 메모리 추적 때문일 수 있습니다. CIT가 APOC보다 더 잘할 수 있는 가장 중요한 일은 메모리 추적입니다! 런타임에 실행되는 모든 Cypher 코드에는 메모리 사용량이 추적됩니다. 사용자 정의 프로시저/함수에는 메모리를 추적하는 기능이 있지만 그 추가는 수년 후에 이루어졌습니다.apoc.주기적.반복작성되었으므로 이 프로시저에는 해당 내용이 없습니다. 메모리 추적은 쿼리가 충돌하고 데이터베이스에 문제를 일으키는 것을 방지합니다. 쿼리가 OOM 문제에 가까워지면 완전히 실패하고 롤백됩니다. OOM 충돌(예: APOC에서 발생할 수 있는 일)의 경우 문제가 훨씬 더 크고 데이터베이스 가동 중지 시간이 발생할 수 있습니다! 이것은 매우 나쁜 문제이며, 분명히 이 APOC 절차의 관에 못 박힌 문제라고 할 수 있습니다.
사용 편의성 및 오류 찾기
하지만 CIT로 전환하면 다른 이점은 무엇인가요?
노드에 새 속성을 추가하고 싶다고 가정해 보겠습니다.즐겨찾기번호. 이 블로그의 목적에 따라 우리는 즐겨찾는 숫자가 항상 0보다 크고 20보다 작거나 같은 임의의 값이라고 가정합니다.
CALL apoc.periodic.iterate(
   'MATCH (n:Person) RETURN elementId(n) AS id',
   'MATCH (n:Person) WHERE elementId(n) = id SET n.favoriteNumber = toInteger(rand() * 20 + 1)',
    {batchSize: 1000}
)

MATCH (n:Person)
CALL (n) {
    SET n.favoriteNumber = toInteger(rand() * 20 + 1)
} IN TRANSACTIONS OF 1000 ROWS
그렇다면 이 두 쿼리의 주요 차이점은 무엇입니까? (APOC의 쿼리가 더 복잡한 이유는 아래에서 논의하겠습니다.) 첫째, 가장 중요한 것은 아니지만 가장 쉽게 볼 수 있는 가독성입니다. Cypher의 CIT 버전에서는 Cypher와 함께 작동하는 모든 도구에서 서식 지정, 자동 완성 적용, 키워드 강조 표시 등을 수행할 수 있습니다. 뿐만 아니라 구문 오류로 인해 조기에 실패합니다.
쿼리에 작은 오타가 있었다고 가정해 보겠습니다.
CALL apoc.periodic.iterate(
    'MATCH (n:Person) RETURN elementId(n) AS id',
    'MATCH (n:Person) WHERE elementId(n) = id SET m.favoriteNumber = toInteger(rand() * 20 + 1)',
    {batchSize: 1000}
)

MATCH (n:Person)
CALL (n) {
    SET m.favoriteNumber = toInteger(rand() * 20 + 1)
} IN TRANSACTIONS OF 1000 ROWS
보이나요? 까다롭죠? 여기서 문제는SET라는 변수를 참조합니다.m이지만 노드 변수는 실제로 호출됩니다.n. 이것이 사용자에게 어떻게 표시되나요? APOC 버전의 경우 쿼리가 작성된 대로 표시되고 실제 Cypher 쿼리는 다음과 같이 표시됩니다.끈값과 그 내용은 모든 도구에서 무시됩니다. 실행 시 결과도 반환됩니다! Hurray는 사용자가 효과가 있었다고 생각하지만 자세히 살펴보면 결과는 다음과 같습니다.
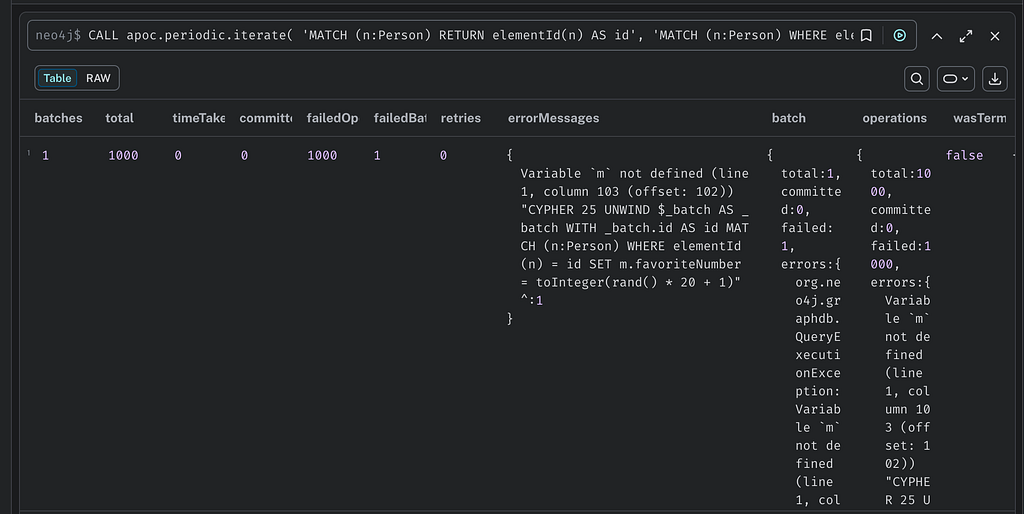
이 오류 메시지는 긍정적인 결과에서 돌아왔을 뿐만 아니라 APOC에서 제공한 일괄 처리 논리가 쿼리 앞에 Cypher 버전을 추가하고절로 인해 쿼리가 작성된 내용과 상당히 다르게 보입니다. 정의되지 않은 변수가 있음을 알 수 있습니다.m이지만 텍스트로도 표시되므로 서식이 지저분해집니다. 훨씬 더 큰 쿼리에서 이 오류를 찾으려고 한다고 상상해 보세요!
Cypher 측에서 해당 쿼리를 입력하면 실행하기도 전에 빨간색 구불구불한 선이 표시됩니다.
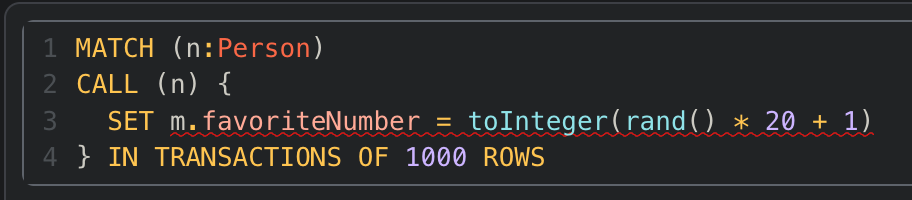
해당 행을 무시하고 이를 실행하면 쿼리 오류가 발생하고 무엇을 해야 할지 알려주는 명확한 메시지가 표시됩니다.

쿼리 계획
그렇다면 가독성을 제외하고 쿼리 계획은 어떻습니까? 쿼리를 조정할 때 Cypher가 쿼리를 어떻게 계획했는지, 쿼리를 변경하기 위해 무엇을 할 수 있는지 아는 것이 좋습니다. 이 경우 계획은 매우 간단합니다.
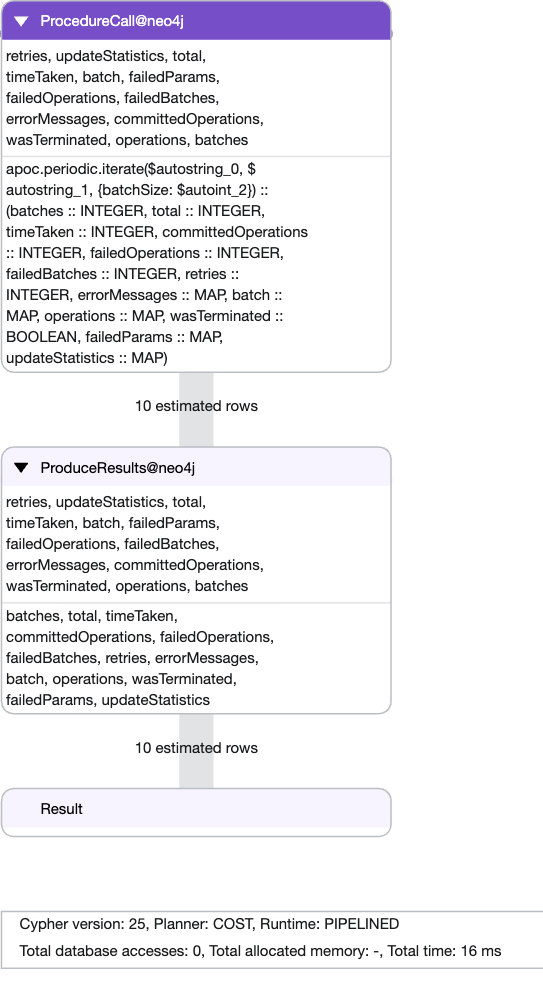
팁: 계획을 생성하려면 쿼리 앞에 EXPLAIN을 추가하세요.
APOC 계획은 매우 간단합니다. 프로시저 호출, 프로시저 결과, 실제 쿼리 실행에 대한 정보 없음, 최적화할 여지 없음.
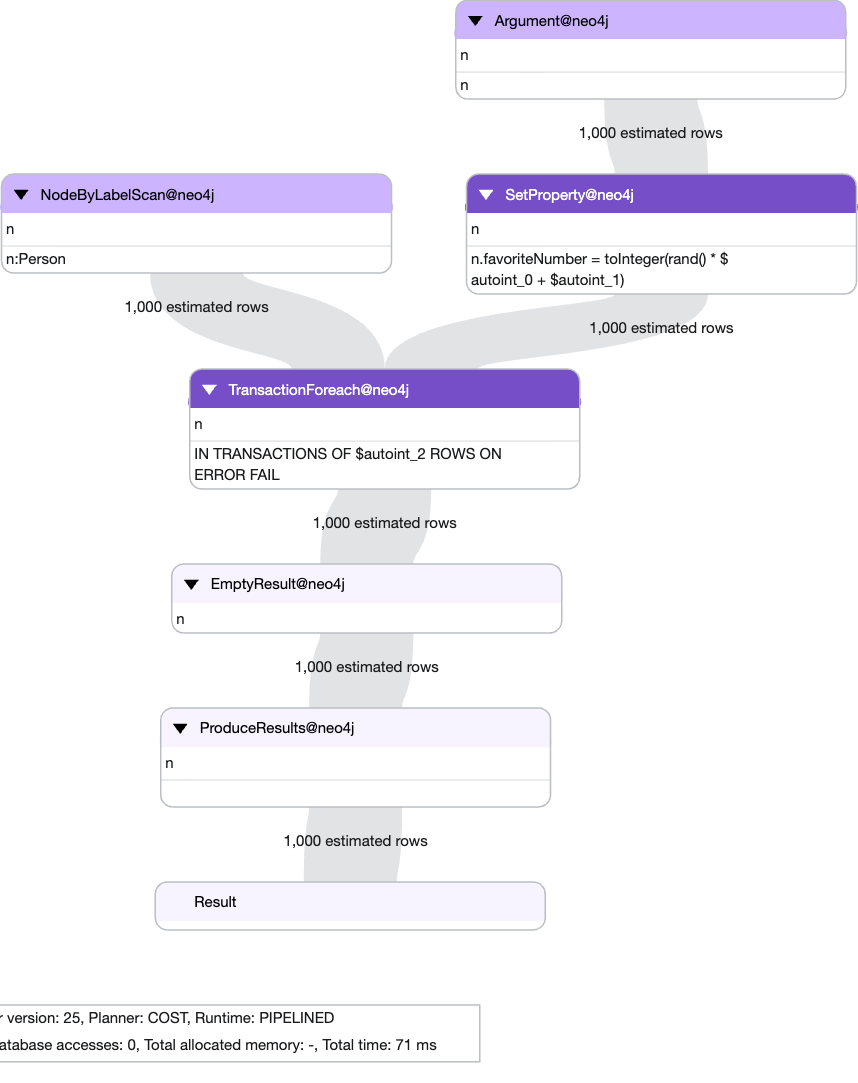
그러나 CIT 변형의 경우 Cypher 엔진은 및 사용을 표시하여 전체 쿼리를 계획할 수 있습니다.! 이것이 더 복잡한 쿼리라면 이 계획이 쿼리 최적화에 어떻게 중요할 수 있는지 알 수 있습니다.
쿼리 통계
Cypher에는 쿼리 통계도 내장되어 있습니다. 쿼리가 실행되면 생성, 업데이트 및 삭제된 노드와 관계 수에 대한 정보가 포함된 결과가 반환됩니다. APOC 실행 쿼리는 변경된 사항이 없다고 믿고 반환하는 반면, Cypher 쿼리는 업데이트된 노드 속성의 수를 사용자에게 올바르게 알려줍니다. APOC는 변경 사항을 결과 집합의 열로 반환하여 통합하지만 내부 쿼리 실행의 모든 결과를 합산하기 때문에 이 결과가 항상 정확하지는 않습니다.
엔터티 리바인딩
APOC 절차의 또 다른 문제는 Neo4j가 노드 및 관계 트랜잭션을 처리하는 방식입니다. 가져온 노드 또는 관계는 가져온 트랜잭션을 참조합니다. 즉, 이 엔터티를 여러 트랜잭션에서 공유하는 것은 절대 금물입니다. 이는 APOC에서 원래 쿼리와 반복 쿼리 간의 노드와 관계를 전달하는 권장되고 유일한 안전한 방법은 엔터티의 ID를 참조하는 것임을 의미합니다. 이것이 예제 쿼리에서 APOC 버전이 노드의요소 ID()그런 다음 재대 결합니다. 이것이 APOC가 부르는 것입니다.. 이는 노드나 관계를 가져오는 작업이 APOC에 의해 두 번, 즉 ID를 가져오는 데 한 번, 해당 ID로 가져오는 데 한 번 수행되어야 하기 때문에 효율성이 떨어집니다. 이 단계를 건너뛰면 OOM 문제 및/또는 잘못된 참조 오류가 발생할 수 있습니다. 이러한 트랜잭션은 Cypher의 런타임 엔진에서 직접 처리되므로 CIT에서는 문제가 되지 않습니다.
동시성
A big benefit of apoc.주기적.반복이었다특징. 이 인수가 true인 경우 APOC는 동시에 실행되는 스레드를 스핀업하여 쿼리 실행 속도를 높일 수 있기를 바랍니다. Cypher의 CIT도 자체적으로 따라잡았습니다.… 동시 거래에서통사론. 참조선적 서류 비치이 기능의 권장 사용법을 알아보세요.
오류 발생 시 재시도
Cypher에서 누락된 마지막 기능은 2025년 초(Neo4j의 2025.03 릴리스)에 추가되었으며오류 발생 시 재시도특징. 이는 최종 APOC 구성 매개변수를 대체합니다.일시적인 오류(즉, 트랜잭션을 재시도하면 다른 결과가 나올 것으로 예상되는 오류)를 방지하는 방법입니다. 이미 존재하는 많은 것들에 추가되었습니다.오류 발생 시CIT에서 제공하는 옵션은 다음을 참조하세요.선적 서류 비치자세한 내용은
향후 개선
우리가 귀하의 사용법을 교체하도록 권장하는 마지막 이유apoc.주기적.반복Cypher의 CIT는 우리 Cypher 엔지니어들이 항상 언어 개선을 위해 열심히 노력하고 있다는 것을 의미합니다. 이는 성능이 항상 향상되고 적시에 버그 수정이 지속적으로 이루어지고 있음을 의미합니다.
APOC 핵심 플러그인은 우리가 부르는 것 아래에 있습니다.유지 관리 모드, 이는 엔지니어링 팀이 이를 적극적으로 개선하거나 새로운 기능을 추가하지 않음을 의미합니다. 버그와 보안 문제는 여전히 수정되어 있지만 이는 APOC보다 Cypher의 CIT에서 개선 사항이 나타날 가능성이 훨씬 더 높다는 것을 의미합니다.
결론
그리고 그게 다였습니다! 여러 트랜잭션으로 실행하려는 Cypher 쿼리가 선택해야 하는 모든 이유 over apoc.주기적.반복! CIT로 전환하면 OOM 충돌과 같은 심각한 오류로부터 애플리케이션을 보호하는 동시에 전반적인 개발자 경험을 향상시키는 더욱 깨끗하고 성능이 뛰어나며 적극적으로 개발된 기능을 선택하게 됩니다.
Cypher를 참조하세요.선적 서류 비치지금 CIT를 시작하는 방법에 대한 도움을 받아보세요!
- APOC
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| 9월 9일, AWS에서 Neo4j AuraDB Enterprise 마스터 되기 (0) | 2026.09.27 |
|---|---|
| Neo4j로 대량 삽입, 자동 인덱싱하고 친구 추천까지 한 번에! (0) | 2026.09.26 |
| ANZ 은행은 어떻게 데이터 기반 인사이트로 DevOps와 클라우드 마이그레이션을 최적화했을까? (0) | 2026.09.26 |
| BambooHR에서 Neo4j로 데이터 연결하기 (0) | 2026.09.26 |
| BambooHR에서 Neo4j로 데이터 연결하기 (0) | 2026.09.26 |