
BambooHR 소프트웨어는 직원 수명 주기 전반에 걸쳐 수집한 모든 정보를 수집하고 정리해서, 훌륭한 성과를 달성하도록 도와준다고 해요. 채용, 온보딩, 보상 준비, 문화 구축 등 무엇을 하든 BambooHR은 가장 중요한 자산인 인력에 집중할 수 있는 도구와 통찰력을 제공해 줄 거예요.
해당 회사 정보는 단순히 표나 개별 기록으로 제공되고 표시되는 경우가 많지만, 본질적으로 그래프, 즉 위치, 팀, 부서 등을 포함한 조직 구조라고 할 수 있죠.
BambooHR은 에서 보듯이 REST API를 제공하는데요. 이는 Neo4j Cypher와 함께 APOC를 사용해서 Bamboo에서 데이터를 추출해서 그래프에 로드할 수 있다는 의미랍니다.
아래 예제에서는 BambooHR에서 직원 기록을 추출하고, 조직도에 해당하는 그래프를 효과적으로 작성하는 방법을 보여줄 거예요.
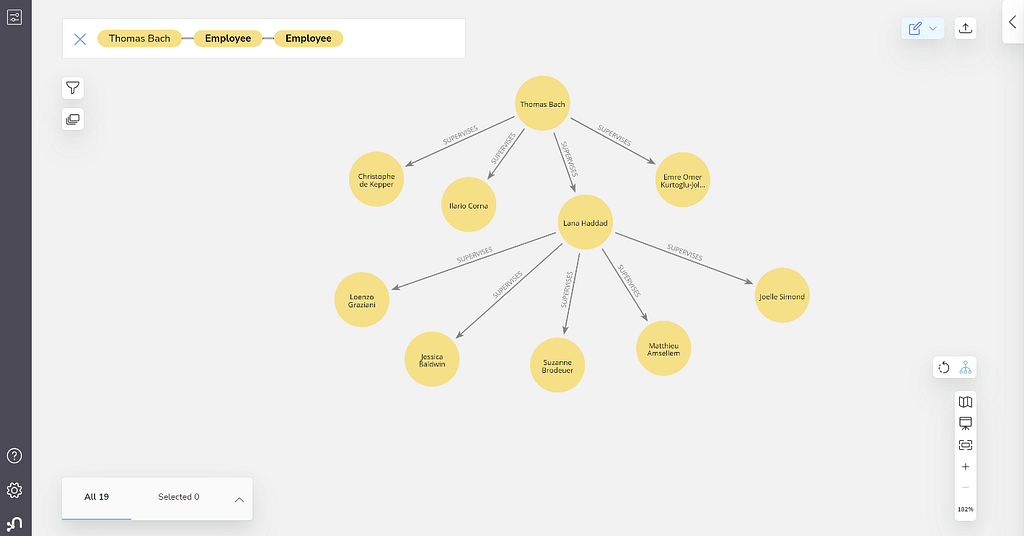
일단 로드되면 Neo4j Browser 또는 Neo4j Bloom을 사용해서 데이터를 시각화할 수 있어요. Bloom의 경우, 특히 계층적 그래프 레이아웃에 사용되는데, 결과는 전통적인 조직도 레이아웃이 될 거예요. BambooHR은 기본적으로 유사한 시각적 조직도 레이아웃을 제공한다는 점에 유의해야 해요. 하지만 Neo4j에서는 데이터를 한 가지 방식으로만 시각화할 필요 없이, 다양한 방식으로 데이터를 `쿼리`하고 탐색하고 확장할 수도 있답니다.
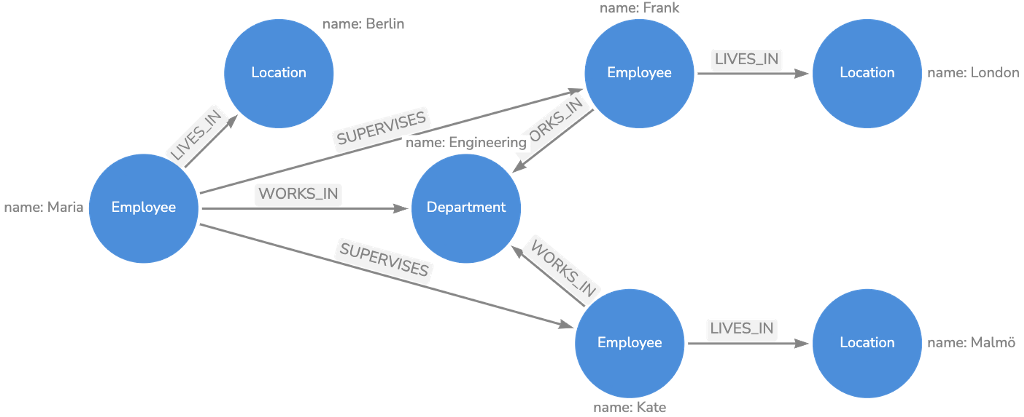
그래프 모델의 경우 다음 `노드`를 사용해요.
- 직원 (Employee)
- 위치 (Location)
- 부서 (Department)
그리고 이러한 `관계`는요:
- (직원)-[:감독]->(직원)
- (직원)-[:LIVES_IN]->(위치)
- (사원)-[:WORKS_IN]->(부서)
다음은 예시 데이터가 포함된 시각적 그래프 모델이에요.
아래 예제의 목적은 BambooHR에서 데이터를 추출하는 것뿐만 아니라, 다른 소스(이메일, Slack 등)의 다른 데이터와의 `관계`를 구축하는 것이기도 해요.
아래 예는 다음 소프트웨어를 사용해서 구성되었어요.
- Neo4j 버전: 4.4.3
- APOC 버전: 4.4.0.1
- 블룸 버전: 2.0.0
그리고 대부분의 경우 Cypher는 수정이 거의 또는 전혀 없이 이전 Neo4j 버전에서 작동할 거라고 생각해요.
// create schema indexes
create constraint on (e:Employee) assert e.id is unique;
create index on :Employee(name);
create constraint on (l:Location) assert l.name is unique;
create constraint on (d:Department) assert d.name is unique;
Bamboo에서 데이터를 로드하고 이전에 표시된 대로 그래프 모델에 삽입해볼게요. 각 데이터 조각에 대해 고유하게 `노드`를 생성하고 (다음을 사용해서 MERGE) `관계`도 마찬가지로 생성할 거예요. supervisor API의 필드에는 ID가 없지만 감독자의 표시 이름이 포함되어 있으므로, 이름이 중복되면 문제가 발생할 수 있다는 점 기억해주세요.
with ‘https://api.bamboohr.com/api/gateway.php/neo4j/v1/employees/directory' as uri,
‘Basic ODI4ZDZmYjViYjNlNmVkYzQ0YmZkNzEyM2Q2YTc0OTlkMzIwOng=’ as bamboo_identifier

CALL apoc.load.jsonParams(uri,
{Authorization: bamboo_identifier, Accept: ‘application/json’},null)

YIELD value

UNWIND value.employees as row

MERGE (e:Employee {id:row.id})

SET e.firstName=row.firstName, e.lastName=row.lastName,
e.workEmail=row.workEmail, e.name=row.displayName,
e.jobTitle=row.jobTitle

MERGE (l:Location {name:row.location})
MERGE (e)-[:LIVES_IN]->(l)

MERGE (d:Department {name:row.department})
MERGE (e)-[:WORKS_IN]->(d)

MERGE (boss:Employee {name:row.supervisor})

MERGE (boss)-[:SUPERVISES]->(e);
원한다면 고용 날짜 같은 추가 정보를 가져올 수도 있어요.
// now GET each employee

MATCH (e:Employee) WHERE e.hireDate IS NULL

WITH e,
'https://api.bamboohr.com/api/gateway.php/neo4j/v1/employees/' + e.id + ‘/?fields=hireDate’ AS uri,

‘Basic ODI4ZDZmYjViYjNlNmVkYzQ0YmZkNzEyM2Q2YTc0OTlkMzIwOng=’ AS bamboo_identifier

CALL apoc.load.jsonParams(uri,{Authorization: bamboo_identifier, Accept: ‘application/json’},null)

YIELD value

set e.hireDate=value.hireDate;
참고:
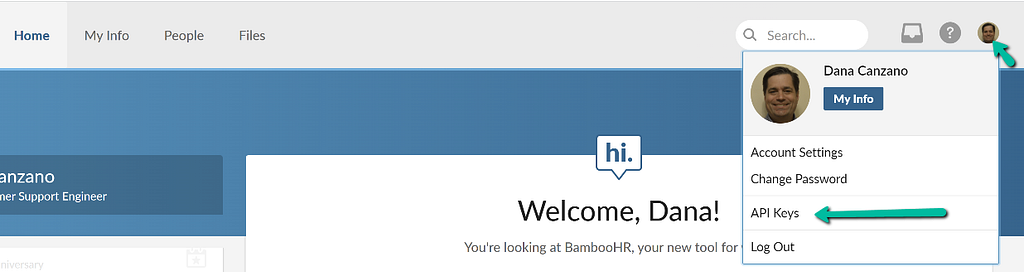
여기서 Basic ODI4ZDZmYjViYjNlNmVkYzQ0YmZkNzEyM2Q2YTc0OTlkMzIwOng= AS bamboo_identifier는 제 Bamboo API 키를 나타내요. 이 키는 BambooHR UI의 오른쪽 상단에 있는 프로필을 클릭하고 API 키를 선택하면 BambooHR 내에서 생성할 수 있어요.
생성된 키를 사용하여 base64로 인코딩하고 :x를 키에 추가하세요. 예를 들어, 생성된 키가 828d6fb5bb3e6edc44bfd7123d6a7499d320라면 다음을 실행해야 해요.
echo -n 828d6fb5bb3e6edc44bfd7123d6a7499d320:x | base64
결과는 다음과 같을 거예요.
ODI4ZDZmYjViYjNlNmVkYzQ0YmZkNzEyM2Q2YTc0OTlkMzIwOng=
그리고 https://api.bamboohr.com/api/gateway.php/neo4j/v1/employees/에 대한 참조가 있는데요. 해당 회사 이름이나 ID를 조직의 도메인으로 업데이트해야 해요.
이제 데이터가 Neo4j에 로드되었으니, 어떤 유형의 쿼리를 실행해볼 수 있을까요?
"Customer Support" 부서에는 몇 명이 근무하나요?
MATCH (:Employee)-[:WORKS_IN]->(d:Department)
WHERE d.name = ‘Customer Support’
RETURN count(*);
최대 2개의 Relationships에 있는 모든 직원을 찾아볼까요?
MATCH path=(boss:Employee)-[:SUPERVISES*..2]->(e:Employee)
WHERE n.jobTitle=’Chief Executive Officer’
RETURN path;
Shortest Path로 나와 다른 직원 사이를 연결해볼 수도 있겠죠:
MATCH path=shortestPath(
   (me:Employee)-[:SUPERVISES*..100]-(other:Employee) )
WHERE me.name = 'My Name' AND other.name = 'Jane Doe'
RETURN path;
요즘 같은 코로나 상황에서는 특정 Location의 모든 직원을 찾는 것도 유용하겠네요.
MATCH (e:Employee)-[:LIVES_IN]->(l:Location)
WHERE l.name STARTS WITH ‘San Mateo’
RETURN e.name, n.workEmail;
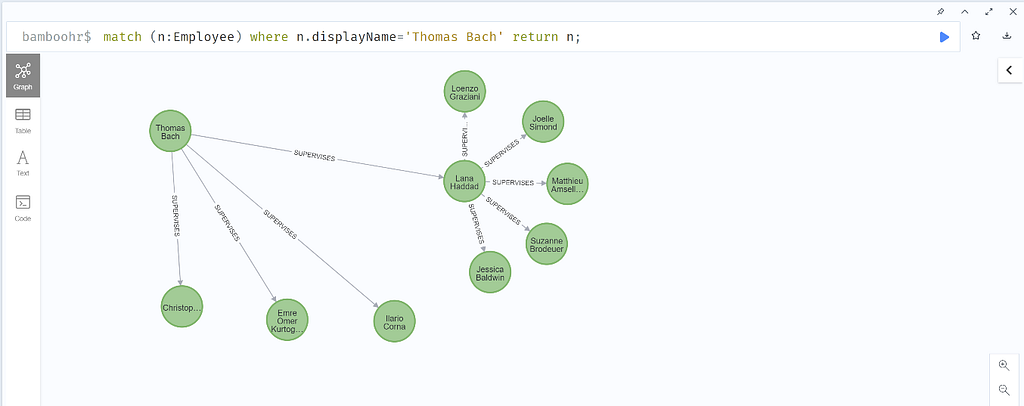
그리고 Neo4j Browser와 Neo4j Bloom 모두에서 데이터가 시각적으로 어떻게 나타나는지 보여주기 위해 공통 데이터세트를 사용할 때 국제 올림픽 위원회 데이터를 사용했어요. 내부 직원 데이터는 공유할 수 없어서 이 공통 데이터 세트를 사용하기로 했답니다.
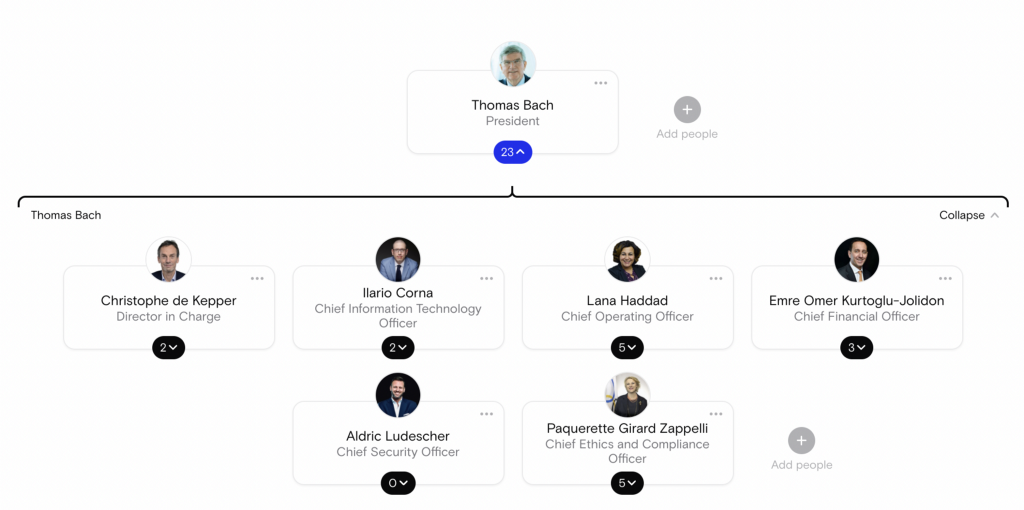
다음은 기본 그래프 표현에서 해당 조직도의 모습이에요.
Neo4j Browser:
Neo4j Bloom:
도움이 되었으면 좋겠네요. BambooHR을 사용하고 있다면 회사 데이터로 한번 시도해 보고, 만들 수 있는 새로운 통찰력이나 시각화로 동료들을 놀라게 해보세요.
- BambooHR
- Data Integration
- Graph
- How To
- Management
- MDM
- Organization
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| ANZ 은행은 어떻게 데이터 기반 인사이트로 DevOps와 클라우드 마이그레이션을 최적화했을까? (0) | 2026.09.26 |
|---|---|
| BambooHR에서 Neo4j로 데이터 연결하기 (0) | 2026.09.26 |
| Backstory.io는 Neo4j로 뉴스를 어떻게 그래프로 만들었나 [커뮤니티 게시글] (0) | 2026.09.26 |
| 5분 인터뷰: Structr 창립자 겸 CEO, Axel Morgner를 만나다 (0) | 2026.09.25 |
| 5분 인터뷰: Structr 창립자 겸 CEO, Axel Morgner를 만나다 (0) | 2026.09.25 |