
- Cypher & GQL
- GraphQL
Cypher는 Neo4j Graph Database에서 사용되는 시각적인 그래프 쿼리 언어에요. 이걸 사용하면 다음과 같이 매우 정확한 패턴 매칭 쿼리를 작성할 수 있죠.
MATCH (movie:Movie {title: “The Matrix”})
       <-[:ACTED_IN]-(person:Person)
WHERE person.born > 1960
RETURN person
이 쿼리는 영화 '매트릭스'에 출연했던 1960년 이후 출생자들을 반환해 줘요.
그런데, 잘 알려지지 않은 기능을 사용하면 GraphQL 출력과 유사한 JSON 형식으로 쿼리 결과를 반환하도록 똑같은 정밀도로 지정할 수 있다는 사실! 이번 포스팅에서는 바로 이 멋진 기능에 대해 알아볼 거예요.
"고전적인" RETURN 구문과 그 "단점"
아주 간단한 예시부터 시작해 볼까요?
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie
이 쿼리를 실행하면 node 표현이 다음과 같은 객체로 반환돼요. (이건 Neo4j Browser에 표시된 결과이고, 특정 드라이버를 통해 쿼리를 실행하면 결과가 다를 수 있다는 점 참고해주세요!)
{
  "identity": 0,
  "labels": [
    "Movie"
  ],
  "properties": {
"tagline": "Welcome to the Real World",
"title": "The Matrix",
"released": 1999
  }
}
좋아요, 훌륭하죠. 하지만 여러분의 애플리케이션에 `tagline`이 필요하지 않을 수도 있잖아요? 전송되는 데이터 크기를 줄이려면 이 필드를 제외하는 게 좋겠죠. 그렇다면 앞의 `RETURN` 구문을 다음처럼 바꿔볼 수 있어요.
RETURN movie.title, movie.released여기서 결과는 상당히 달라져요. JSON 요소를 포함하는 단일 열 대신, 두 개의 열로 구성된 결과가 생성되거든요.
╒═════════════╤════════════════╕
│"movie.title"│"movie.released"│
╞═════════════╪════════════════╡
│"The Matrix" │1999            │
└─────────────┴────────────────┘
이제 같은 쿼리에서 이 영화에 참여한 배우도 검색하고 싶다고 가정해 볼게요. 다음과 같이 작성해야겠죠?
MATCH (movie:Movie {title: “The Matrix”})
       <-[:ACTED_IN]-(person:Person)
RETURN movie.title, movie.released, person.name
이렇게 하면 중복된 정보가 많이 포함된 테이블이 반환돼요.
╒═════════════╤════════════════╤════════════════════╕
│"movie.title"│"movie.released"│"person.name"       │
╞═════════════╪════════════════╪════════════════════╡
│"The Matrix" │1999            │"Emil Eifrem"       │
├─────────────┼────────────────┼────────────────────┤
│"The Matrix" │1999            │"Hugo Weaving"      │
├─────────────┼────────────────┼────────────────────┤
│"The Matrix" │1999            │"Laurence Fishburne"│
├─────────────┼────────────────┼────────────────────┤
│"The Matrix" │1999            │"Carrie-Anne Moss"  │
├─────────────┼────────────────┼────────────────────┤
│"The Matrix" │1999            │"Keanu Reeves"      │
└─────────────┴────────────────┴────────────────────┘
영화 제목과 개봉일이 영화 속 배우 수만큼 반복되다니! 그렇다면 이런 반복을 피하고 항상 일관된 데이터 유형을 반환하려면 어떻게 해야 할까요?
지도 투영 사용
지도 투영은 GraphQL에서 영감을 받은 Cypher 기능이에요. GraphQL을 모른다면 여기서 유일하게 관련된 특징은 각 쿼리의 반환 필드를 맞춤설정하는 기능이라는 점!
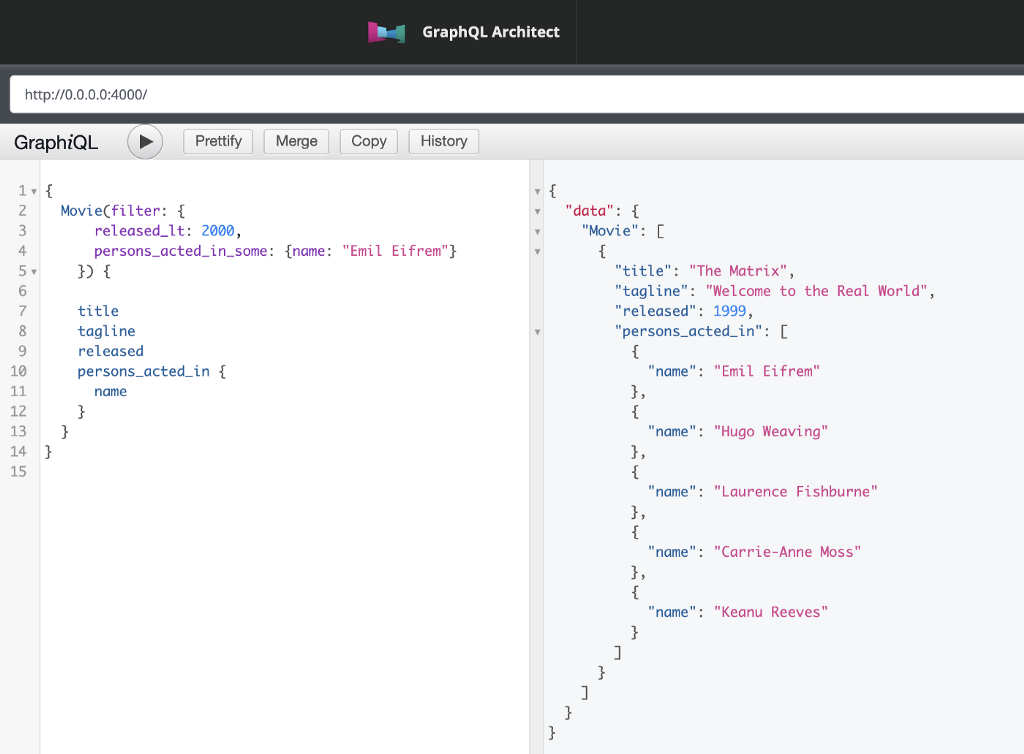
Cypher를 사용하면 다음과 같이 작성할 수 있어요.
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie {.title, .released }
이 쿼리는 이름이 지정된 단일 열이 있는 단일 행을 반환하는데, movie 안에는 올바른 형식의 JSON이 들어있죠.
{
  "title": "The Matrix",
  "released": 1999
}
와일드카드 *를 사용할 수도 있어요. 특정 Node의 모든 Property를 검색하려는 경우에 유용하겠죠?
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie {.* }
단일 배열로 결과 'collect'하기
쿼리와 일치하는 영화가 여러 개 있으면 어떻게 될까요? 다음과 같이 작성하면
MATCH (movie:Movie)
RETURN movie { .title, .released }
여러 행을 포함하는 결과를 얻게 돼요. 각 행은 위의 객체와 비슷하죠. 단일 JSON 배열을 원한다면 collect를 사용할 수 있어요:
MATCH (movie:Movie)
RETURN collect(movie { .title, .released })
이번에는 다음과 유사한 JSON 요소 배열을 얻게 됩니다.
[
  {
    "title": "The Matrix",
    "released": 1999
  },
  {
    "title": "The Matrix Reloaded",
    "released": 2003
  },
....
]
벌써 좋은 결과네요! 하지만 계속해서 배우를 포함해 보도록 하죠.
관계 순회
이제 특정 영화에 출연한 사람을 검색하려고 해요. 이건 MATCH 구문 덕분에 가능하죠:
MATCH (movie:Movie {title: "The Matrix"})
       <-[:ACTED_IN]-(person:Person)
순회된 관계 collect하기
지도 투영 내에서 이전에 MATCH된 요소(예: movie와 person)에 액세스할 수 있어요:
MATCH (movie:Movie {title: "The Matrix"})
       <-[:ACTED_IN]-(person:Person)
RETURN movie {
          .title,
          actors: collect( person { .name } )
       }
이 새로운 구문에서는 actors라는 새 키를 최종 결과에 추가해요. 이 값은 특정 영화에 대해 일치하는 모든 person을 collect하여 만들어지며, name Property를 추출하죠 (이전 예에서 여러 영화를 검색한 것처럼).
{
  "title": "The Matrix",
  "actors": [
    {
      "name": "Emil Eifrem"
    },
    {
      "name": "Hugo Weaving"
    },
    {
      "name": "Laurence Fishburne"
    },
    {
      "name": "Carrie-Anne Moss"
    },
    {
      "name": "Keanu Reeves"
    }
  ]
}
좋아요. 그런데 검색하려는 대상이 MATCH 구문인가요?
프로젝션에서 관계 순회 (로컬 범위)
맵 프로젝션은 패턴을 이해하는 기능도 있어서 문제없어요. 따라서 이전 쿼리는 다음 쿼리와 동일하답니다.
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie {
     .title,
     actors: [(movie)<-[:ACTED_IN]-(person:Person)
| person { .name }
            ]
}
앞의 예제에서는 Cypher list comprehension을 사용해서 결과를 파싱하고 있어요. 쿼리의 굵은 글씨 부분은 실제로 "movie에 출연한 모든 `Person`을 찾고, 각각의 이름을 추출해줘"라는 의미랍니다. 이 쿼리의 결과는 이전 쿼리의 결과와 똑같아요 (단, `Person`이 반환되는 순서는 보장되지 않아요).
관계 데이터 추출
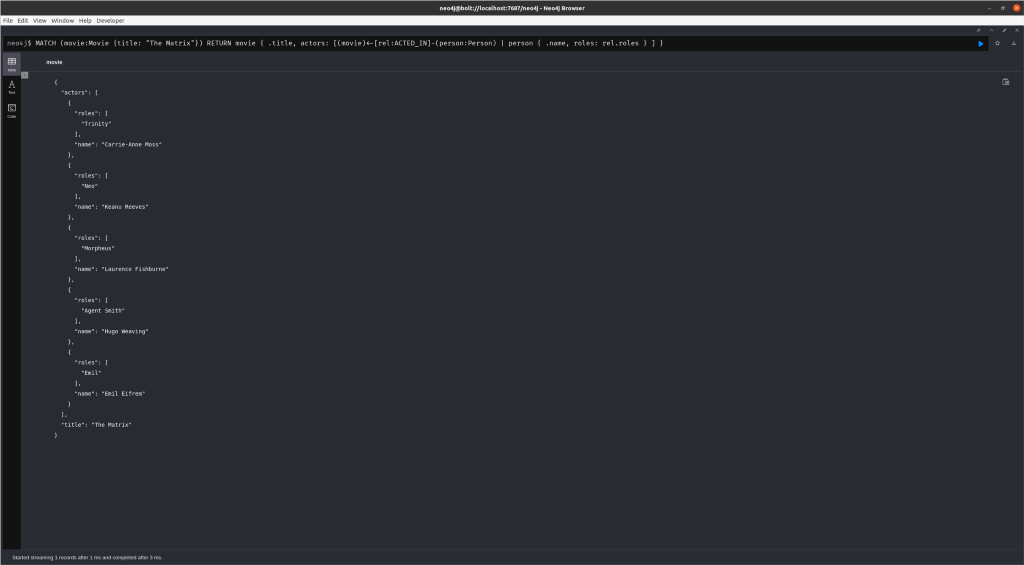
`Person`에 대한 관련 `Node` 데이터를 검색하는 방식과 비슷하게, 관계 속성을 추출할 수 있어요. 다음 쿼리에서는 ACTED_IN 관계의 roles 속성을 가져오고 있어요:
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie {
     .title,
     actors: [(movie)<-[rel:ACTED_IN]-(person:Person)
                 | person { .name,roles: rel.roles }
            ]
}
WHERE 절로 결과 제한
일반 Cypher를 사용하면 WHERE 절을 사용해서 관련 `Node`에 제약 조건을 추가할 수 있어요:
MATCH (movie:Movie {title: "The Matrix"})
       <-[:ACTED_IN]-(person:Person)
WHERE person.born > 1965
RETURN movie, person
이건 맵 프로젝션에서도 똑같이 가능해요:
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie {
     .title,
     actors: [(movie)<-[:ACTED_IN]-(person:Person)
WHERE person.born > 1965
                 | person { .name }
            ]
}
두 경우 모두, 결과에는 1965년 이후에 태어난 배우만 포함된답니다.
페이지 매기기: 정렬 기준, 제한, 건너뛰기 (또는 오프셋)
이런 식으로 작성하고 싶을 수도 있겠죠:
MATCH (movie:Movie {title: “The Matrix”})
RETURN movie {
     .title,
     actors: [(movie)<-[:ACTED_IN]-(person:Person)
               WHERE person.born > 1965
               ORDER BY person.born LIMIT 1 SKIP 2
                 | person { .name }
            ]
}
하지만 2022년 3월, 그리고 Neo4j 4.4 현재는 이게 (아직?) 불가능해요.
다행히 APOC 플러그인을 사용하면 비슷한 결과를 얻을 수 있어요. apoc.coll.sortMaps 함수는 이 예제에서 'born'이라는 특정 키를 기준으로 맵 목록을 정렬해준답니다.
MATCH (movie:Movie {title: "The Matrix"})
RETURN movie {
     .title,
     actors: apoc.coll.sortMaps(
              [
                 (movie)<-[:ACTED_IN]-(person:Person)
                 | person {.name, .born }
               ],
"born"
             )[0..3]
}
마지막의 [0..3] 선택자를 사용하면, 생년월일별로 정렬된 처음 세 명의 배우만 반환할 수 있어요.
맵 프로젝션은 언제 사용하나요?
GraphQL 컨텍스트에 맵 프로젝션을 도입해서, 데이터베이스에서 필요한 필드만 가져와 GraphQL 쿼리를 더 쉽게 활용할 수 있게 되었어요 (백엔드에서 다른 필터링 계층을 거칠 필요 없이!). 하지만 제가 좋아하는 이 개념의 또 다른 활용법은 "객체 그래프 매퍼" (OGM)를 쉽게 작성할 수 있다는 점이에요. "도메인" 스키마와 다른 그래프 스키마를 가지고 있으면서도, 맵 프로젝션 덕분에 적절한 객체를 계속 구축할 수 있다고 상상해보세요. 다음은 제품과 카테고리를 표시하는 그래프 스키마의 예시랍니다.
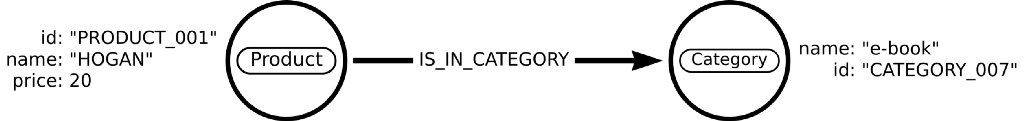
다음과 같이 Product 모델이 속한 카테고리에 대한 정보가 포함된 모델의 경우, map projection을 사용해서 get_products 함수를 만들 수 있어요. 이 함수는 Product의 모든 필드가 포함된 객체를 반환하죠.
참고: 이전 예제에서는 단순하게 제품이 하나의 카테고리에만 속한다고 가정했어요. 여러 카테고리에 속하는 경우를 다루려면 Product.cateogry의 타입을 list[str]로 변경해서 적용해 보세요.
결론
여기까지에요! Map projection이 무엇인지, 그리고 언제 유용하게 사용할 수 있는지 이해하는 데 도움이 되었으면 좋겠네요.
참고 자료
- GraphQL에서 영감을 받은 새로운 Cypher 기능 [Neo4j 3.1 미리보기]
- Cypher map projection 문서
- APOC 문서
- API용 쿼리 언어인 GraphQL
- Neo4j Python 드라이버
- GraphQL
- json
- Map Projection
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| Bolt 프로토콜, 최신 업데이트 소식! (0) | 2026.09.02 |
|---|---|
| 임시 Neo4j 데이터베이스를 위한 라이브러리 (0) | 2026.09.01 |
| Neo4j Enterprise Edition을 위한 Production급 PrivateLink 설정 완벽 가이드 (0) | 2026.08.31 |
| 2017 GraphConnect Europe에 꼭 참석해야 할 9가지 이유 (0) | 2026.08.31 |
| 2019년, Neo4j 블로그 Top 8: 놓치면 후회할 꿀팁 대방출! (0) | 2026.08.29 |