
- Graph Data Science
이전 기사에서, k-medoids를 사용해서 그래프 데이터를 클러스터링하는 장점에 대해 이야기했었죠. k-medoids 방식에서는 그래프를 나눌 클러스터의 개수를 정하게 되는데요. 이 숫자를 k라고 해요. 알고리즘은 k개의 medoids라고 불리는 그래프의 `Node` 집합을 식별합니다. 그래프의 다른 `Node`들은 그래프에서 가장 가까운 medoid에 해당하는 클러스터에 할당되죠. 알고리즘은 `Node`와 해당 medoid 사이의 거리 합계를 최소화하기 위해 medoid 집합을 찾는답니다.
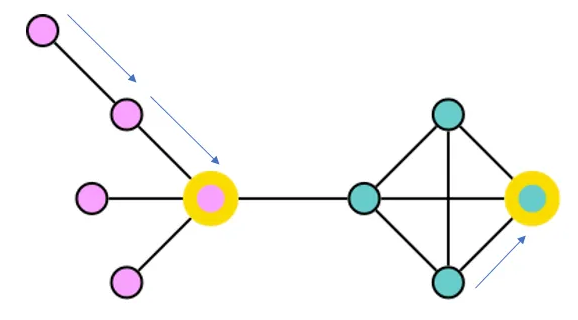
k-medoids 방식은 그래프 데이터에 여러 가지 이점을 제공하는데요. K-medoids는 데이터 세트의 모든 예제 쌍 사이의 거리를 할당하는 데 사용할 수 있는 메트릭이 있다면 어떤 거리 메트릭으로든 작동할 수 있다는 점이에요. 그래프 데이터의 경우, 두 `Node` 사이의 최단 경로의 가중치 또는 비가중 길이를 거리 측정법으로 사용할 수 있어요. 이는 유클리드 거리를 가장 자주 사용하는 k-평균과 같은 알고리즘에 비해 장점이 될 수 있죠. 유클리드 거리는 일부 변환 없이는 그래프 토폴로지에 적용하기 어렵거든요.
k-medoids의 또 다른 장점은 알고리즘이 반환하는 medoids가 해당 클러스터를 대표하는 일반적인 예시가 될 수 있다는 점이에요. 덕분에 클러스터링 결과를 이해 관계자에게 쉽게 설명할 수 있답니다.
다음과 같은 일부 k-medoids 구현의 중요한 단점은요, PAM(Partitioning Around Medoids) 알고리즘은 알고리즘을 실행하기 전에 모든 `Node` 쌍 사이의 거리를 계산해야 한다는 거예요. Neo4j Graph Data Science에는 All Pairs Shortest Path 알고리즘이 있지만, `Node`가 수천 개 이상인 그래프의 경우 실행 속도가 느릴 수 있다는 점 기억해주세요!
이곳은 CLARANS (CLARAN for Clustering Large Applications Based upon Randomized Search) 알고리즘이 유용할 수 있는 곳이에요. Raymond T. Ng와 Jiawei Han은 이전 k-medoid 알고리즘보다 더 큰 데이터 세트로 k-medoid를 확장하기 위해 CLARANS를 개발했어요. CLARANS는 모든 노드를 잠재적인 메도이드로 꼼꼼하게 고려하는 대신 가능한 메도이드의 하위 집합을 무작위로 검색해요. 즉, 모든 노드 쌍 사이의 거리를 미리 계산할 필요가 없죠. 필요에 따라 거리를 계산할 수 있어요. 그래프에서 최단 경로의 일부만 계산하면서 최적의 솔루션에 대한 적절한 근사치를 얻을 수 있다는 점이 중요해요.
CLARANS 알고리즘
Ng와 Han은 CLARANS의 단계를 그래프 문제로 설명했어요. 그들은 각 노드가 일련의 k개의 잠재적인 메디이드를 나타내는 그래프를 상상했죠. 잠재적인 메디이드 중 하나를 제외하고 모두 공유하는 경우 노드는 후보 그래프에서 서로 관련돼요. 기본 데이터도 그래프이므로 기본 데이터를 "기본 그래프"로 참조하고 메디이드 후보 세트의 오버레이를 "후보 그래프"로 참조할게요.
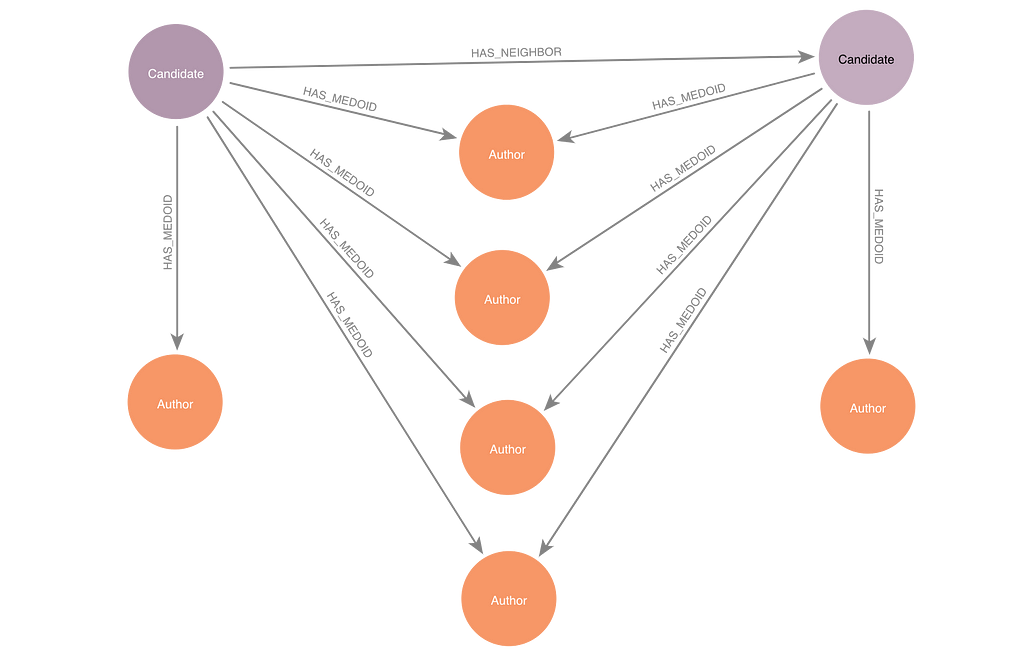
알고리즘 실행이 시작되면 CLARANS는 후보 그래프에서 임의의 노드를 선택하여 검색을 시작해요. 이 노드는 후보 노드에요. 알고리즘은 각 기본 그래프 노드에서 가장 가까운 메도이드까지의 거리를 계산해요. 이 총 거리는 현재 후보자에게 점수를 부여하죠.
그런 다음 CLARANS는 현재 후보자의 무작위로 선택된 이웃의 점수를 확인하여 현재 후보자보다 점수가 낮은지 확인하기 시작해요. 각 이웃 노드에는 현재 후보와 공통된 메도이드 중 하나를 제외한 모든 노드가 있으므로 이 단계에서는 하나의 메도이드를 무작위로 선택된 다른 메도이드로 교체하는 효과를 테스트하는 거예요. 낮은 점수를 가진 이웃 후보 노드를 찾으면 즉시 현재 노드가 되고, 낮은 점수를 받은 후보를 찾기 위해 이웃을 검색하기 시작해요. CLARANS에는 다음과 같은 하이퍼파라미터가 포함되어 있어요: . 알고리즘은 검색된 현재 후보 노드의 이웃 수를 계산해요. 카운트가 에 도달하기 전에 총 거리 점수를 향상시키는 노드를 찾지 못하면 알고리즘의 반복이 완료되는 거죠.
CLARANS 알고리즘을 임의의 노드에 있는 후보 그래프에 드롭되는 웹 크롤러로 생각해 보세요. 점수가 더 낮은 노드를 찾을 때까지 해당 노드의 이웃을 검색해요. 그런 다음 크롤러는 해당 이웃으로 이동하여 다음에 의해 정의된 시도 횟수 내에서 낮은 점수의 이웃을 찾을 수 없을 때까지 검색을 반복해요: . 크롤러가 로컬 최소값에 갇혀 그래프의 다른 부분에서 더 낮은 점수를 놓칠 수도 있어요. 이러한 이유로 CLARANS에는 다음과 같은 또 다른 하이퍼파라미터가 포함되어 있답니다: . 이 값은 알고리즘이 후보 그래프의 임의의 새 위치에서 시작되는 횟수를 나타내요. 시작점이 두 개 이상 있으면 웹 서핑자가 전역 최소 점수에 가까운 값을 찾을 확률이 높아지겠죠?
Python 및 Neo4j에서 CLARANS 구현
The pyclustering library에는 표 형식 데이터에 대한 CLARANS의 Python 구현이 포함되어 있어요. 그만큼 프로젝트 노트북에서는 Neo4j Graph Data Science와 그래프 데이터 과학 Python 클라이언트를 사용하여 CLARANS를 그래프 데이터에 적용하는 방법을 보여줄 거예요.
K-메도이드 알고리즘은 기본 그래프의 각 노드에서 각 메도이드까지의 거리를 계산할 수 있다고 가정해요. 이는 그래프의 각 노드에서 그래프의 다른 노드까지의 경로가 있어야 함을 의미하죠. 연결이 끊어진 그래프가 있는 경우 약하게 연결된 구성 요소(WCC)를 실행하는 것이 클러스터링을 향한 좋은 첫 번째 단계에요. WCC 결과를 검토한 후 CLARANS와 같은 클러스터링 알고리즘을 사용하여 가장 큰 WCC 구성 요소의 구조를 추가로 분석할 수 있어요.
find_giant_comComponent 함수는 그래프 투영에서 가장 큰 연결 구성요소를 기반으로 하위 그래프를 생성해요. 또한 Cypher를 사용하여 이러한 노드를 효율적으로 `Query`할 수 있도록 가장 큰 구성요소의 노드에 새 라벨을 적용한답니다.
def find_giant_component(projection, wccProperty, subgraph_name, subgraph_node_label): # Mutate the graph with wcc id so we can use it for filtering gds.wcc.mutate(projection, mutateProperty=wccProperty) # Write the wcc id to the graph so we can use it for filtering in Bloom gds.graph.nodeProperties.write(projection, wccProperty) # Get the id of the giant component wcc_df = gds.graph.nodeProperties.stream(projection, wccProperty) biggest_component_id = wcc_df['propertyValue'].value_counts().idxmax() # Filter the projection to the giant component subgraph, result = gds.graph.filter(subgraph_name, projection, f"n.{wccProperty} = {biggest_component_id}", "*") gds.run_cypher(f"""MATCH (n) WHERE n.wccId = $biggestComponentId CALL apoc.create.addLabels(n, [$subgraphNodeLabel]) YIELD node RETURN count(*) AS nodesUpdated""", {"biggestComponentId": biggest_component_id, "subgraphNodeLabel": subgraph_node_label}) return subgraph, result, biggest_component_id
create_new_candidate 함수는 무작위로 k개의 기본 그래프의 node를 선택해서 메도이드 후보 세트로 사용해요. 그러면 후보 그래프 검색이 시작되죠. Neo4j 데이터베이스에서 검색에 대한 감사 추적을 생성하기 위해 후보 그래프의 node를 Neo4j에 저장해요. 각 후보 node는 HAS_MEDOID 관계에 의해 설정된 해당 후보 내의 메도이드에 연결돼요.
def create_new_candidate(k, label):
    candidate_df = gds.run_cypher(f"""MATCH (g:{label})
                                     WITH g ORDER BY rand()
                                     LIMIT $k
                                     WITH collect(g) AS medoids
                                     CREATE (c:Candidate)
                                     WITH c, medoids
                                     UNWIND medoids as m
                                     MERGE (c)-[:HAS_MEDOID]->(m)
                                     RETURN id(c) AS candidate_id
                                     LIMIT 1""",
                                  {"k":k, "label": label})
    return candidate_df.iloc[0,0]
계산_candidate_cost 함수는 각 메도이드에서 기본 그래프의 모든 node까지의 거리를 계산해요. 이 거리는 Delta Stepping Single Source Shortest Path 연산을 사용해서 계산하고요. 이 알고리즘은 그래프의 한 node에서 도달 가능한 다른 모든 node까지의 최단 경로를 찾아요. Neo4j에서 이러한 최단 경로의 길이를 기록하기 위해 기본 그래프의 node 쌍 사이에 HAS_DISTANCE 관계를 생성해요. 이렇게 하면 메도이드가 다른 후보의 일부로 재사용될 때 다시 계산할 필요가 없죠. 그래프에 많은 관계가 생성되므로 효과적으로 실행하려면 Neo4j 인스턴스에 사용 가능한 저장 공간이 충분해야 해요.
기본 그래프는 방향이 없기 때문에 node a로부터 node b까지의 거리는 node b로부터 node a까지의 거리와 같아요. Neo4j의 Delta-Stepping Single Source Shortest Path 구현은 HAS_DISTANCE 관계가 이미 다른 방향에 존재하는 대상 node를 필터링하는 쉬운 방법을 제공하지 않아요. 이로 인해 일부 중복 계산이 발생하지만, 제가 실행한 테스트 사례에서는 생성된 HAS_DISTANCE 관계 중 10% 미만이 반대 방향의 기존 관계와 중복되는 것으로 나타났어요.
각 메도이드에서 기본 node까지의 거리를 계산한 후에는 각 기본 node에 대해 어떤 메도이드가 가장 가까운지 결정할 수 있어요. 기본 node에서 가장 가까운 메도이드까지의 거리의 합이 이 후보 메도이드 세트의 점수가 되죠. CLARANS 문서에서는 기본 node부터 현재 할당된 메도이드, 두 번째로 가까운 메도이드, 교체된 메도이드까지의 거리를 비교하는 점수 매기기 메커니즘에 대해 설명하고 있어요. 우리 함수의 Cypher 문은 가장 가까운 메도이드를 찾기 위해 후보와 관련된 모든 메도이드까지의 거리를 조사해요. 이 비교는 CLARANS 논문의 비교보다 Cypher로 표현하기가 더 쉽죠. 우리의 접근 방식은 큰 k 값에 대한 CLARANS 논문의 접근 방식보다 약간 덜 효율적일 수 있어요.
def calculate_candidate_cost(projection, candidate_id):
    #If distances to all other nodes are not already present for each medoid,
    # calculate the missing distances
    gds.run_cypher("""
                      MATCH (c)-[:HAS_MEDOID]->(m)
                      WHERE id(c) = $candidateId
                      AND NOT EXISTS {(m)-[:HAS_DISTANCE]->()}
                      WITH m
                      CALL gds.allShortestPaths.delta.write(
                          $graphName,
                          {writeRelationshipType: "HAS_DISTANCE",
                          sourceNode: id(m)})
                      YIELD relationshipsWritten
                      RETURN relationshipsWritten
                          """,
                   {"candidateId": candidate_id,
                    "graphName": projection.name()})
    #Calculate the cost for this group of candidate medoids
    cost_df = gds.run_cypher("""
                      MATCH (c)-[:HAS_MEDOID]->(m)
                      WHERE id(c) = $candidateId
                      MATCH (m)-[d:HAS_DISTANCE]->(n)
                      WITH c, m, n, d
                      ORDER BY d.totalCost ASC
                      WITH c, n, collect(d.totalCost) AS costList
                      WITH c, n, costList[0] AS closestMedoidCost
                      WITH c, sum(closestMedoidCost) AS totalCost
                      SET c.totalCost = totalCost
                      RETURN totalCost""",
                  {"candidateId": candidate_id})
    return cost_df.iloc[0,0]
create_neighboring_candidate 함수는 Neo4j에서 현재 후보의 인접 후보 Node를 생성해요. 현재 후보와 생성되는 새 후보 사이에 HAS_NEIGHBOR Relationship을 생성하죠. 이렇게 하면 Neo4j Bloom에서 검색 단계를 시각적으로 추적할 수 있어요. Python에서 현재 점수와 현재 medoid 세트를 추적해서 이 감사 추적 없이 CLARANS를 구현할 수도 있고요.
def create_neighboring_candidate(candidate_id, k, label):
    new_candidate_df = gds.run_cypher(f"""
         MATCH (c:Candidate)
         WHERE id(c) = $candidateId
         MATCH (g:{label})
         WHERE NOT EXISTS {{(c)-[:HAS_MEDOID]->(g)}}
         WITH c, g
         ORDER BY rand()
         LIMIT 1
         MATCH (c)-[:HAS_MEDOID]->(m)
         WITH c, g, m
         ORDER BY rand()
         LIMIT $k -1
         WITH c, g, collect(m) AS medoids
         WITH c, medoids + g AS newMedoids
         CREATE (newCandidate:Candidate)
         WITH c, newCandidate, newMedoids
         MERGE (c)-[:HAS_NEIGHBOR]->(newCandidate)
         WITH newMedoids, newCandidate
         UNWIND newMedoids as newMedoid
         MERGE (newCandidate)-[:HAS_MEDOID]->(newMedoid)
         RETURN id(newCandidate) AS newCandidateId
         LIMIT 1""",
       {"candidateId": candidate_id,
        "k": k,
        "label": label})
    return new_candidate_df.iloc[0, 0]
run_clarans 함수는 모든 조각을 모아서 CLARANS 알고리즘을 실행해요. max_neighbor 및 num_local 값을 전달할 수 있는데, 그렇지 않으면 이 함수는 CLARANS 문서에 제안된 기본값을 사용하죠. Ng와 Han은 num_local 값이 2이면 일반적으로 좋은 결과를 얻기에 충분하다는 것을 발견했어요. 값이 높을수록 실험 결과가 크게 개선되지 않고 알고리즘이 더 오래 실행되었고요.
후보 그래프의 각 후보 Node에는 k(n – k) 잠재적인 이웃이 있어요. 이는 각각의 k 후보 세트의 medoid는 n – k 기본 그래프의 다른 Node 중 하나로 교체될 수 있다는 의미죠. 검색하는 이웃의 비율이 높을수록 전역 최소 점수에 가까워질 확률이 높아져요. Ng와 Han은 실험을 통해 가능한 전체 이웃의 1.25~1.5%를 검색하면 최적의 결과와 빠른 실행 시간 사이의 균형이 잘 맞는다는 사실을 발견했대요. 우리의 Python 구현은 함수를 호출할 때 값이 지정되지 않은 경우 max_neigbhor를 가능한 전체 이웃의 1.25%로 계산해요.
def run_clarans(projection, k, label, num_local=2, max_neighbor=None, verbose=False): #If max_neighbor was not provided, calculate 1.25% times k(n-k) if max_neighbor == None: node_count_df = gds.run_cypher(f"""MATCH (n:{label}) RETURN count(*) as nodeCount""") node_count = node_count_df.iloc[0,0] max_neighbor = round(k*(node_count-k)*0.0125) if verbose: print(f"max_neighbor: {max_neighbor}") min_cost = 999999999 # The i counter keeps track of the number of times we begin the search at a new randomly selected candidate node i = 1 while i <= num_local: current_candidate_id = create_new_candidate(k, label) current_cost = calculate_candidate_cost(projection, current_candidate_id) if verbose: print(f"Starting search from candidate {current_candidate_id} with cost {current_cost}") # The j counter keeps track of the number of times we have checked a neighbor of the currently selected node j = 1 while j <= max_neighbor: neighbor_candidate_id = create_neighboring_candidate(current_candidate_id, k, label) neighbor_cost = calculate_candidate_cost(projection, neighbor_candidate_id) if verbose: print(f"Neighbor cost: {neighbor_cost}") if neighbor_cost < current_cost: j = 1 current_candidate_id = neighbor_candidate_id current_cost = neighbor_cost if verbose: print(f"Current cost: {current_cost}") else: j = j + 1 if current_cost < min_cost: min_cost = current_cost best_candidate_id = current_candidate_id if verbose: print(f"Min cost: {min_cost}") i = i + 1 return best_candidate_id, min_cost
두 개의 그래프에서 CLARANS 테스트
다음에서 다운로드한 두 개의 그래프 데이터세트에서 CLARANS를 테스트해봤어요. 대화형 그래프 분석 및 시각화를 갖춘 네트워크 데이터 저장소. 제가 연구에 사용한 첫 번째 데이터세트는 작은 유전학 그래프였는데요, 이전 k-medoids 기사에서도 사용했었죠. 이 데이터 세트에는 1,400개의 Node와 1,600개의 Relationship이 있어요.
두 번째 데이터세트는 저자 공동작업 데이터세트인데요, 12,000개의 Node와 118,500개의 Relationship으로 구성되어 있답니다.
그래프 기반 CLARANS 구현을 FasterPAM k-medoid 알고리즘과 비교해봤어요. FasterPAM은 kmedoid Python 패키지를 사용했고요. FasterPAM 접근 방식을 사용하려면 All Pairs Shortest Path를 실행해서 Neo4j Graph Data Science에서 그래프의 모든 Node 쌍을 나타내는 거리 행렬을 생성해야 해요.
소규모 유전자 데이터 세트의 결과
더 작은 유전자 데이터 세트의 경우 CLARANS에 대한 기본값인 num_local과 max_neighbor를 사용했을 때 실행하는 데 약 249초가 걸렸어요. FasterPAM 접근 방식은 All Pairs Shortest Path 실행 시간을 포함해서 68초가 걸렸고요. FasterPAM의 총 거리 점수는 CLARANS의 점수보다 약 8% 낮았어요. FasterPAM 접근 방식이 실행하는 데 시간이 덜 걸리고 더 나은 점수를 제공하니까, 이 데이터 세트에 사용하는 것이 훨씬 더 나은 알고리즘이겠죠?
이 데이터 세트에 대한 CLARANS 결과가 FasterPAM보다 좋지는 않지만, 알고리즘 작동 방식이 명확하기 때문에 Neo4j Bloom의 CLARANS 후보를 계속 살펴보고 싶었어요.
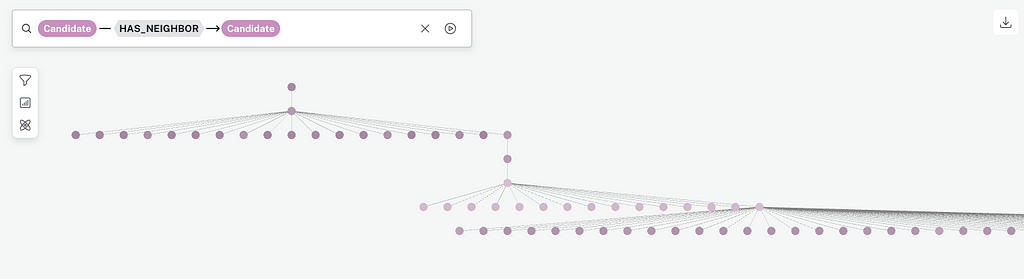
점수에 따라 후보 Node에 색상을 지정하는 Bloom 관점을 설정했는데요, 색상이 어두울수록 점수가 높음(나쁨)을 의미해요. 계층적 레이아웃을 사용했기 때문에 처음 검색된 후보자가 디스플레이 상단에 표시되고 나중에 검색된 후보자가 아래에 표시된답니다. Candidate — HAS_NEIGHBOR-Candidate를 검색했어요.
아래 전체 데이터 시각화 부분은 위쪽에 어두운 보라색 `Candidate`로 시작해서 검색이 진행될수록 밝은 `Node`로 이동하는 하나의 검색을 보여줘요. 이미지 하단을 보면 CLARANS가 여러 이웃을 확인했지만, 마지막 줄 오른쪽에 있는 후보보다 점수가 낮은 이웃은 찾지 못한 걸 확인할 수 있죠. Bloom에서는 `Candidate` Node에 대한 `HAS_MEDOID` Relationship을 마우스 오른쪽 버튼으로 클릭하고 확장해서 연관된 메디이드를 볼 수 있어요.
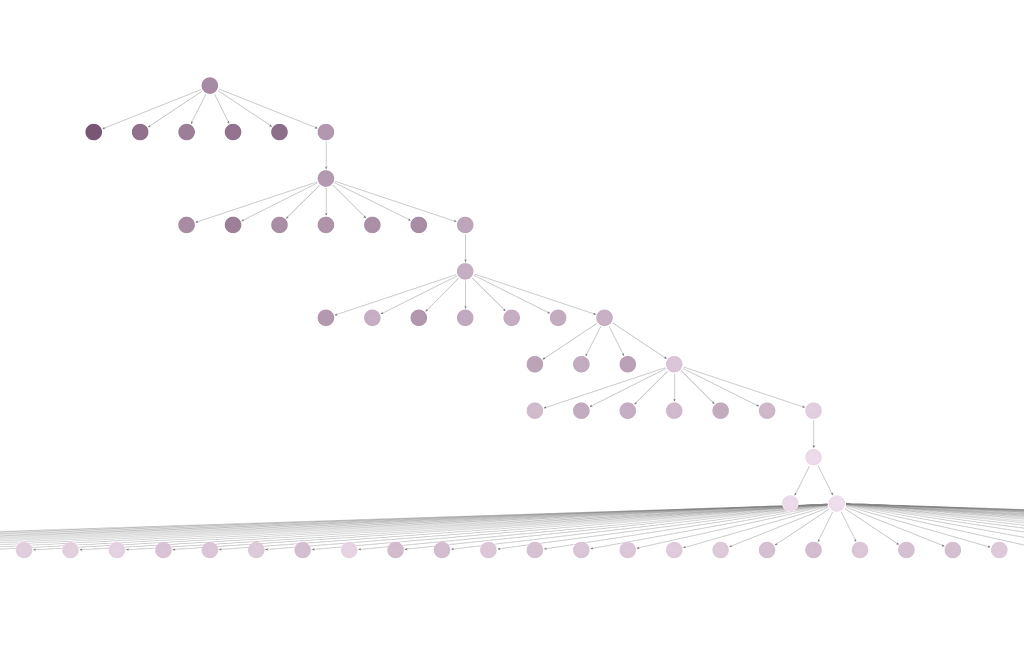
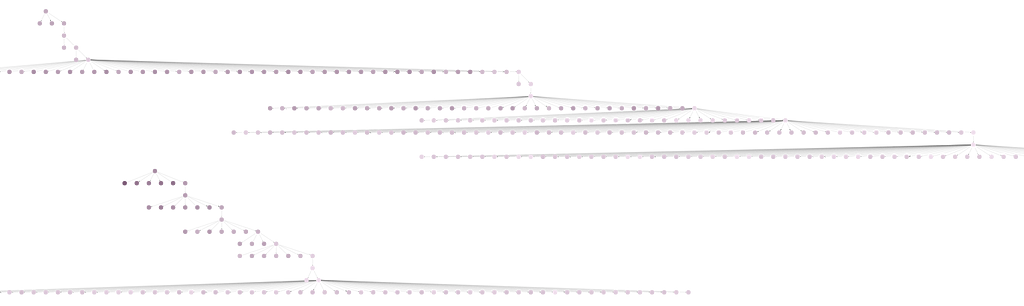
Bloom 관점을 축소하면 두 개의 별도 트리가 표시되는데요. `num_local`이 2로 설정되었기 때문이에요. 두 검색 모두에서 가장 낮은 점수를 받은 후보가 결과로 반환되었어요.
대규모 저자 공동 작업 데이터 세트에 대한 결과
대규모 작성자 공동 작업 데이터 세트의 경우, 가장 작은 Aura DS 인스턴스(8GB 메모리, 2 CPU)에는 모든 `Node` 최단 경로를 실행하기에 충분한 리소스가 없었어요. 두 가지 크기(24GB 메모리, 5 CPU)의 Aura DS 인스턴스를 업그레이드한 후 모든 `Node` 최단 경로를 실행할 수 있었지만, 완료하는 데 2.5시간 이상이 걸렸죠. 이는 FasterPAM 알고리즘을 사용하는 데 큰 병목 현상이었어요.
제 CLARANS 구현은 가장 작은 Aura DS 인스턴스에서 성공적으로 실행될 수 있었어요. FasterPAM에 사용한 인스턴스에 맞게 Aura DS를 업사이징한 후 CLARANS는 23분 만에 완료되었어요. CLARANS의 총 거리 점수는 FasterPAM 점수와 6% 미만의 차이를 보였죠. 제한된 시간이나 시스템 리소스로 인해 작업 중인 크기의 그래프에 대한 모든 `Node` 최단 경로를 미리 계산할 수 없는 경우, CLARANS가 좋은 대안이 될 수 있어요.
저자 데이터세트의 경우, CLARANS가 그래프에서 가능한 총 최단 경로의 32%를 계산해서 최적의 메디이드에 대한 근사치를 생각해 낼 수 있다는 것을 발견했어요.
위의 `calculate_candidate_cost`에 대한 설명에서 설명한 제한으로 인해 일부 거리는 두 번 계산되었지만, 거리의 90%는 한 번만 계산되었어요. 이러한 중복 계산을 줄이면 최적화할 여지가 있지만, 전체 성능에 큰 영향을 미치지는 않는 것 같아요.
작성자 데이터세트의 경우 `max_neighbors`가 훨씬 크기 때문에 Bloom 시각화는 작은 유전자 데이터세트보다 큰 작성자 데이터세트에 대해 작업하기가 더 어려워요. 하지만 이 클로즈업 사진은 트리 중 하나의 세부정보를 보여주죠.
결론
k-medoid 알고리즘의 대부분의 Python 구현에는 데이터 세트의 모든 항목 쌍 사이의 거리를 사전 계산해야 해요. 유클리드 거리처럼 거리 측정법이 계산하기 쉬운 경우, 이 사전 계산은 병목 현상이 발생하지 않아요. 그러나 k-medoid 알고리즘을 그래프 데이터에 적용할 때 모든 `Node` 쌍 사이의 최단 경로를 찾는 것은 매우 비용이 많이 들 수 있죠.
CLARANS는 그래프에서 가능한 최단 경로 중 상대적으로 작은 비율을 계산해서 최적의 메도이드에 근접한 메도이드를 발견하는 방법을 제공해요. 중형 및 대형 그래프의 경우 다른 k-medoid 접근 방식에 비해 런타임이 향상되므로 CLARANS가 좋은 선택이에요.
- 클러스터링
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| 협업 기반 기술 정보 플랫폼 (0) | 2026.10.13 |
|---|---|
| 협업 필터링: 최고의 팀을 만드는 비법 (0) | 2026.10.12 |
| K-Medoids로 그래프 데이터 클러스터링하기 (0) | 2026.10.12 |
| Aura 인스턴스 복제로 개발 주기 최적화하기 (0) | 2026.10.12 |
| 마르코프 체인으로 CLI 자동 완성 기능 제대로 업그레이드하기 (0) | 2026.10.12 |