
예측 모델링은 데이터 과학자에게 가장 기본적인 작업 중 하나이고, 해당 분야의 거의 모든 직업과 산업에서 접하게 될 거예요. 지식과 기술을 최신 상태로 유지하는 건 회사의 효율성과 수익을 높이는 데 필수적이죠.
이 글에서는 패키지 설치, 데이터 읽기, 모델 구성의 미묘한 차이를 포함해서 Python에서 예측 모델을 구축하는 방법을 단계별로 알아볼 거예요.
예측 모델링 기초
예측 모델링은 통계 모델을 사용해서 과거 데이터로부터 미래를 예측하는 거예요. 이 방법은 수학적 원리를 바탕으로 모델을 개발하는 것과, 그 모델을 실제 데이터에 적용하는 것을 모두 의미할 수 있어요. 데이터 과학자는 일반적으로 기존 모델을 사용해서 예측하는 후자에 더 관심이 많죠.
업계에서 일상적으로 사용되는 예측 모델링의 예시를 몇 가지 살펴볼까요?
- 소셜 미디어 사이트에서 콘텐츠 위반 게시물 식별
- 금융 주식의 미래 가치를 예측
- 보험에서 보험금이 청구될 가능성 추정
- 광고 캠페인의 효과 예측
물론 이건 여러분 또는 여러분의 팀이 조직 효율성을 높이기 위해 예측 모델링을 사용할 수 있는 다양한 방법 중 일부에 불과해요.
예측 모델 구축 단계
예측 모델 구축에 대한 세부 사항을 살펴보기 전에, Python, 사용하는 프로그래밍 언어에 관계없이 예측 모델링의 기본 단계를 이해하는 것이 중요해요. 이러한 기본 작업을 살펴볼게요.
1. 데이터세트 수집 및 정리
예측 모델을 구축하는 첫 번째 단계는 모델을 구축할 데이터를 수집하는 거예요. 모델에는 변수가 예측하려는 결과에 어떤 영향을 미치는지 참조할 수 있는 데이터가 필요하죠.
직장에서 여러분의 회사는 여러분의 데이터를 `Query`하기 위해 MySQL, MongoDB 또는 Neo4j와 같은 소프트웨어로 만든 데이터베이스를 제공할 거예요. 하지만 스스로 웹사이트에서 데이터를 다운로드하거나 웹에서 스크랩해서 데이터를 얻을 수도 있어요.
2. 데이터 세트 정리
데이터 세트를 처음 열 때 "깨끗"하지 않은 경우가 많아요. 몇 가지 예를 들자면:
- 열 값의 철자가 다릅니다 (예: "주" 열에 "Texas" 및 "TX" 포함).
- 잘못된 소수점 또는 단위(예: 달러가 아닌 센트로 된 가격 정보)
- 누락된 데이터(예: "NULL", "NA" 또는 "NaN"으로 레이블이 지정된 값이 있음)
누군가가 데이터를 잘못 표시할 수 있는 방법은 무한하기 때문에, 이러한 문제를 해결하기 위한 "모든 경우에 적합한" 접근 방식은 없어요. 최적의 전략은 각 문제를 독립적으로 해결하는 것에 대해 비판적으로 생각하는 거죠. 몇 가지 모범 사례는 다음과 같아요.
- 설명이 포함된 "숫자" 데이터(예: 우편번호)를 실제 숫자로 처리하지 마세요.
- 일반적으로 누락된 데이터를 0이나 평균으로 바꾸는 것보다 삭제하는 것이 좋아요.
- 정확하게 있는지 확인하세요. one 카테고리에 라벨을 붙이는 방법입니다(“소형”, “소형” 및 “S”와 같은 것은 안돼요).
3. 방법론/알고리즘 선택
다음 단계는 예측을 생성하는 데 사용할 모델을 선택하는 거예요. 선택할 수 있는 모델이 가지나 되는데, 모델 범위를 좁히는 한 가지 방법은 상황에 맞는 **회귀** 또는 **분류** 모델을 선택하는 거예요.
**회귀** 모델은 특정 변수의 값, 즉 주식 가격에 대한 수치적 추정을 출력해요. **분류** 모델은 데이터 포인트가 속하는 "클래스" 또는 "카테고리"에 대한 설명을 출력하죠 (예: 누군가가 대출을 불이행하는지 여부).
회귀 모델과 분류 모델 중 하나를 선택하려면 스스로에게 물어보세요. 여러분이 원하는 출력이 무엇인지 말이죠. 출력이 숫자이면 회귀 모델을 사용하고, 카테고리라면 분류 모델을 사용하세요.
어떤 특정 모델을 선택해야 할지에 대해서는 Sklearn 사용자 가이드를 자유롭게 검토해서 다양한 모델에 대한 높은 수준의 개요를 확인해보세요.
4. 모델 구축
마지막 단계는 모델을 구축하고 `Fine-tuning`하는 거예요. 데이터가 준비되면 모델 학습을 위한 표준 형식을 따를 수 있으므로 이 단계는 가장 간단해요. 또한 제공한 데이터에 대해 모델이 얼마나 잘 작동하는지 평가하는 것도 쉽죠.
Python의 예측 모델링
어떤 프로그래밍 언어를 사용하든 언어별 패키지, 함수 및 구문을 사용해야 해요. Python도 마찬가지죠.
데이터 과학자는 일반적으로 NumPy, pandas 및 scikit-learn 패키지를 통해 Python에서 예측 모델링을 수행할 수 있어요. Pandas와 NumPy는 데이터를 로드하고 조작하는 데 도움이 되고, scikit-learn을 사용하면 예측 모델을 구축할 수 있죠. 더 전문화된 모델은 추가 패키지를 사용할 수도 있어요.
Python에서 예측 모델을 구축하는 방법
Python을 사용해서 예측 분석을 하는 방법을 보여드리기 위해, 어떤 대출 기관이 대출을 불이행할지 예측하는 예시를 사용해볼게요. 이 과정은 다음 세 단계로 요약할 수 있어요.
- Python 라이브러리 설치 및 가져오기
- 데이터 탐색, 구성 및 정리
- 모델 구축 및 평가
시작해볼까요?
1. Python 패키지 설치 및 가져오기
먼저 데이터를 로드하고 모델을 생성하는 데 필요한 패키지를 설치할 거예요. 모델링을 위해 Jupyter Notebook을 사용하는 걸 추천해요. Raw Python 파일보다 코드 결과를 쉽게 확인할 수 있거든요.
Python과 Jupyter가 이미 설치되어 있다고 가정하고, Powershell(Windows) 또는 터미널(Mac 또는 Linux)을 열어서 다음 명령을 입력하세요.
pip install matplotlib numpy pandas scikit-learn그다음, 다음 명령어를 사용해서 Jupyter Notebook을 실행합니다.
jupyter notebook
“새로 만들기” 드롭다운 메뉴를 클릭하고 “python”을 선택해서 새로운 노트북을 만들어 주세요.
패키지를 가져오려면 노트북 시작 부분에 다음 명령문을 넣고 실행하면 돼요.
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np
2. 데이터 탐색, 정리 및 구성
Python 패키지가 준비됐다면, 이제 모델링을 위해 데이터를 다운로드할 차례예요.
다음 링크에서 데이터셋을 다운로드하세요: . archive.zip 파일의 압축을 풀고 train_LZV4RXX.csv 파일을 작업 디렉토리로 옮겨주세요.
이제 데이터 탐색을 시작할 준비가 끝났어요!
데이터 세트 읽기
데이터 세트를 노트북으로 읽어오려면 pandas의 read_csv 함수를 사용하면 됩니다.
raw_data = pd.read_csv('train_LZV4RXX.csv',index_col='loan_id')혹시 실수를 할 수도 있으니, 수정하지 않은 데이터는 수정하려는 데이터와 별도의 변수에 저장하는 게 좋아요.
data = raw_data.copy(deep=True)데이터 세트 탐색
DataFrame을 표시하려면 셀 끝에 변수 이름을 추가하고 셀 코드를 실행하면 돼요.
data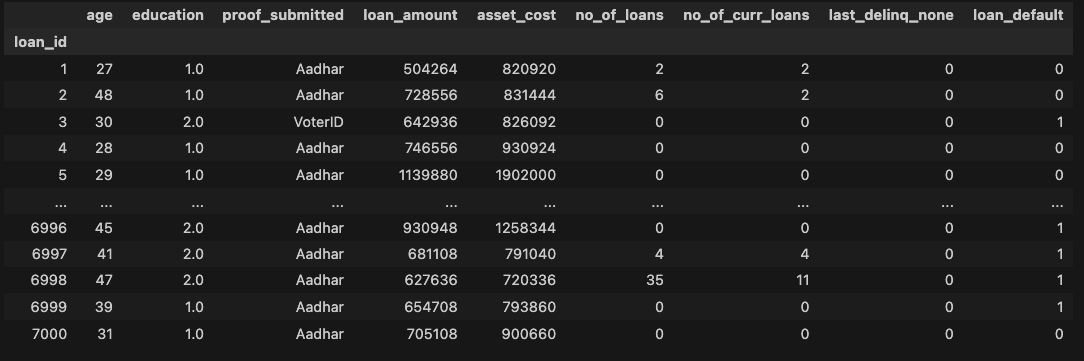
이 테이블에서 `loan_default`는 'target column', 즉 다른 column을 사용해서 예측하는 column이에요. '1'은 차용인이 채무를 불이행했다는 뜻이고, '0'은 대출금을 전부 상환했다는 의미랍니다.
여기서 살펴볼 만한 두 가지 상황이 있어요.
- 'education' column에는 값으로 '1'과 '2'만 있네요. 이건 label이 잘못 지정된 범주형 column일 수 있다는 걸 나타내요.
- `proof_submitted`는 범주형 field니까, 철자 오류나 중복된 category가 없는지 확인해야 해요.
특정 column의 값만 얻고 싶다면, 다음과 같이 원하는 column 이름으로 data 변수를 indexing할 수 있어요.
data['proof_submitted']
loan_id
1       Aadhar
2       Aadhar
3       VoterID
4       Aadhar
5       Aadhar
        ...
6996    Aadhar
6997    Aadhar
6998    Aadhar
6999    Aadhar
7000    Aadhar
Name: proof_submitted, Length: 7000, dtype: object
특정 column의 고유한 값을 찾으려면 `unique` 메서드를 사용하세요.
data['proof_submitted'].unique()
array(['Aadhar', 'VoterID', 'Driving', 'PAN', 'Passport'], dtype=object)
data['education'].unique()
array([ 1.,  2., nan])
'proof_submitted' column에는 중복 항목이 없는 것 같지만, 'education' column에는 최소한 일부 누락된 값('nan'으로 표시)이 있네요.
일반적으로 결측값이 있는 data point를 제거하려고 할 수도 있지만, 이런 사례는 탐색적 데이터 분석 중에 신중하게 고려해야 할 필요성을 보여주는 것 같아요. 'education'의 다른 값은 '1'과 '2'뿐이니까, 'nan'은 '0' class를 나타낸다고 가정할 수 있겠죠. 그러니까 'nan'은 고등학교 중퇴자, '1'은 고등학교 졸업, '2'는 대학교 졸업 정도가 될 거예요. 모델에 data를 공급하기 전에 이런 수정 사항을 반영하도록 이 column을 수정하세요.
이제 범주형 column을 다뤘으니, 숫자 column으로 넘어가 볼게요. 수치 data를 한눈에 볼 수 있는 가장 쉬운 방법은 히스토그램을 그리는 거예요.
data.drop(['education','loan_default'],axis=1).plot(kind="density",subplots=True, sharex=False, figsize=(30,30),xlim=0)
plt.show()
다음 링크에서 plot에 전달된 인수가 어떤 역할을 하는지 확인할 수 있어요: pandas documentation
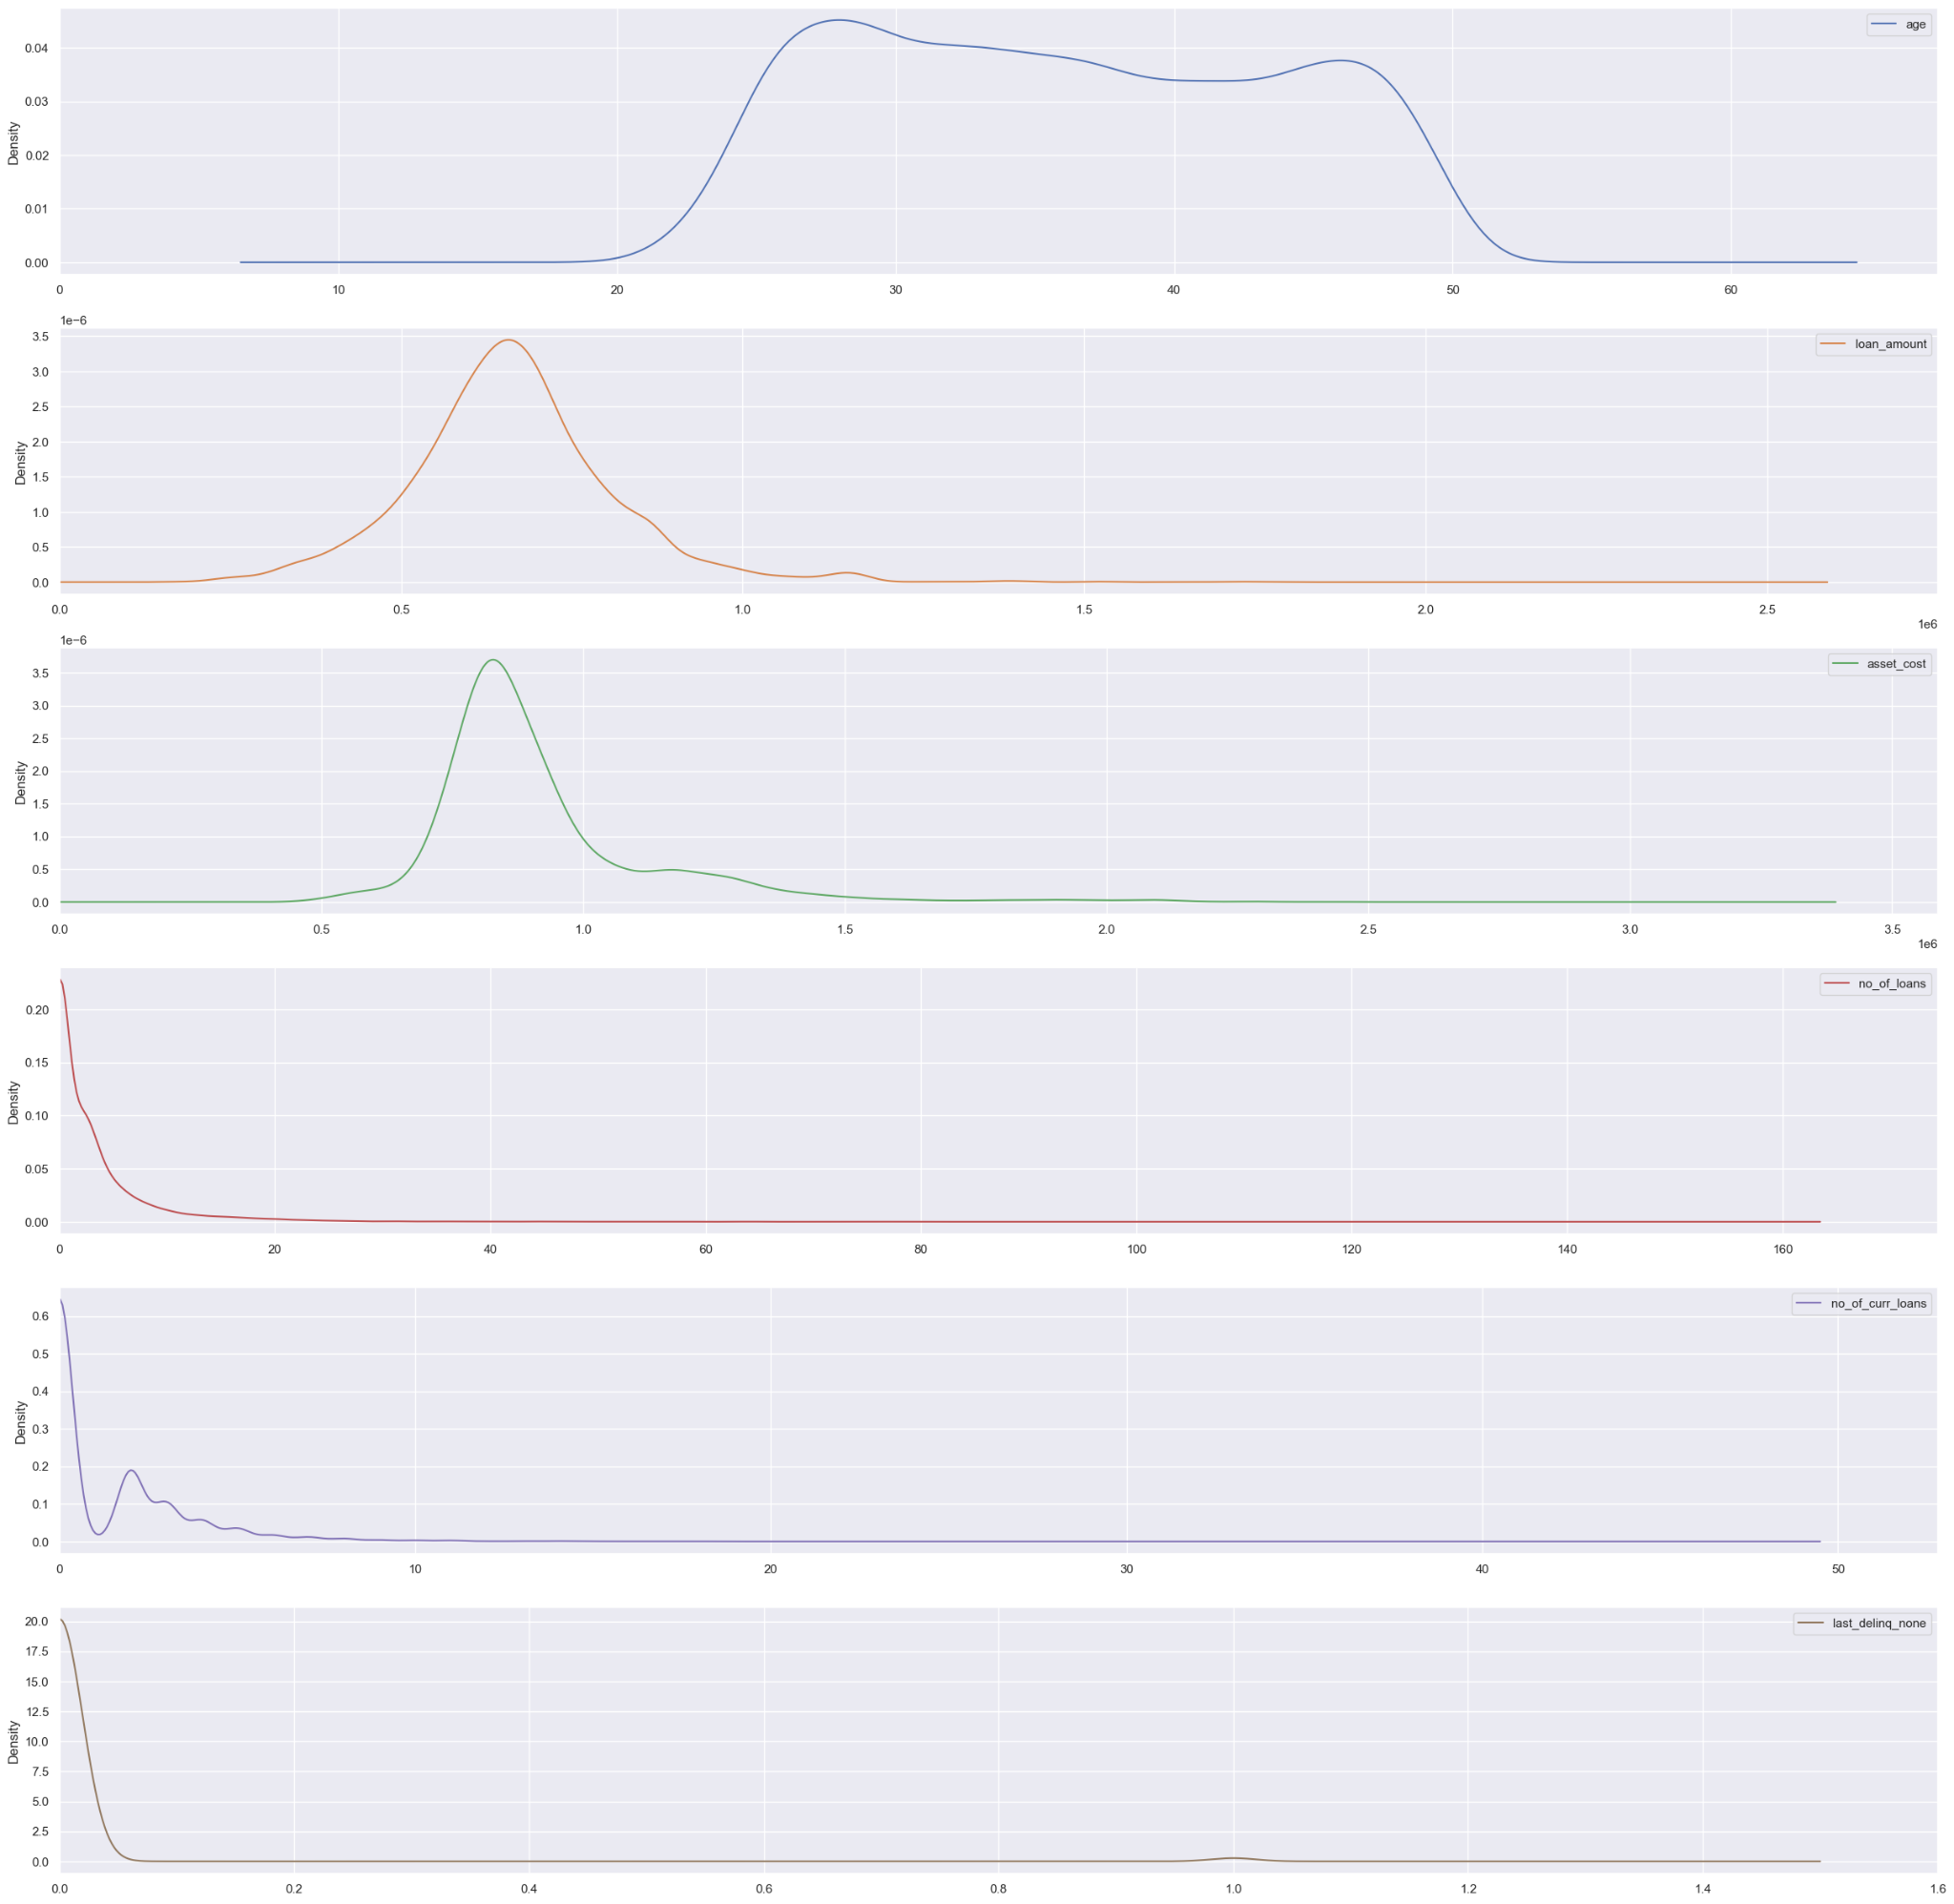
밀도 도표를 보니까 모든 변수의 분포가 괜찮은 것 같아요. 척도를 수정하거나 이상값을 제거할 필요는 없겠어요. last_deliqn_none은 부울 열이니까 0과 1을 중심으로 분포되어 있네요.
마지막으로 확인해야 할 것은 '클래스 불균형' 문제인데요. 대상 열의 한 클래스가 데이터에서 너무 많이 나타나는 경우를 말해요.
data.groupby("loan_default").count()/len(data)이 코드 셀에서는:
groupby가loan_default열을 기준으로 데이터를 묶어주고요.count는 각 클래스의 인스턴스 수를 세어서 데이터를 집계해 줘요.len(data)로 나누면 값이 실제 개수가 아니라 백분율로 표시되는 거죠.
loan_default
False   0.6
True    0.4
Name: age, dtype: float64
데이터 세트에는 채무 불이행을 하지 않은 사람이 더 많네요. 이런 불균형은 문제가 될 수 있어요. 왜냐하면 이 데이터를 사용해서 만든 모델은 자동으로 불이행하지 않을 사람들을 더 잘 예측하도록 편향될 수 있거든요.
다행히 모델을 만들 때 데이터세트가 불균형하다는 것을 지정하면 이 문제를 아주 쉽게 해결할 수 있어요.
데이터세트 정리
이제 데이터를 간단히 살펴보고 뭘 바꿔야 할지 알았으니, 모델에 넣을 수 있도록 데이터를 정리하고 수정해야겠죠?
먼저 'education' 열부터 수정해 볼게요. 열의 각 값(1, 2, 그리고 nan)을 다른 범주에 할당하고, 이걸 열에 적용하는 함수를 만들어 봅시다.
def get_education_category(education_value):
   if education_value == 1:
       return "Group_1"
   elif education_value == 2:
       return "Group_2"
   elif np.isnan(education_value):
       return "Group_3"


data["education"] = data["education"].apply(get_education_category)
데이터 조작
데이터가 정리되었으니, 마지막으로 데이터를 조작해서 모델에 전달할 수 있게 만들어야 해요.
이 단계에서 중요한 건 두 개의 범주형 열(education과 proof_submitted)에 대해 "더미 열"을 만드는 거예요. scikit-learn 모델은 문자열이 아니라 숫자만 읽을 수 있거든요. get_dummies 함수를 사용하면 필요한 열을 빠르게 만들 수 있어요.
data = pd.get_dummies(data,columns=['education','proof_submitted'])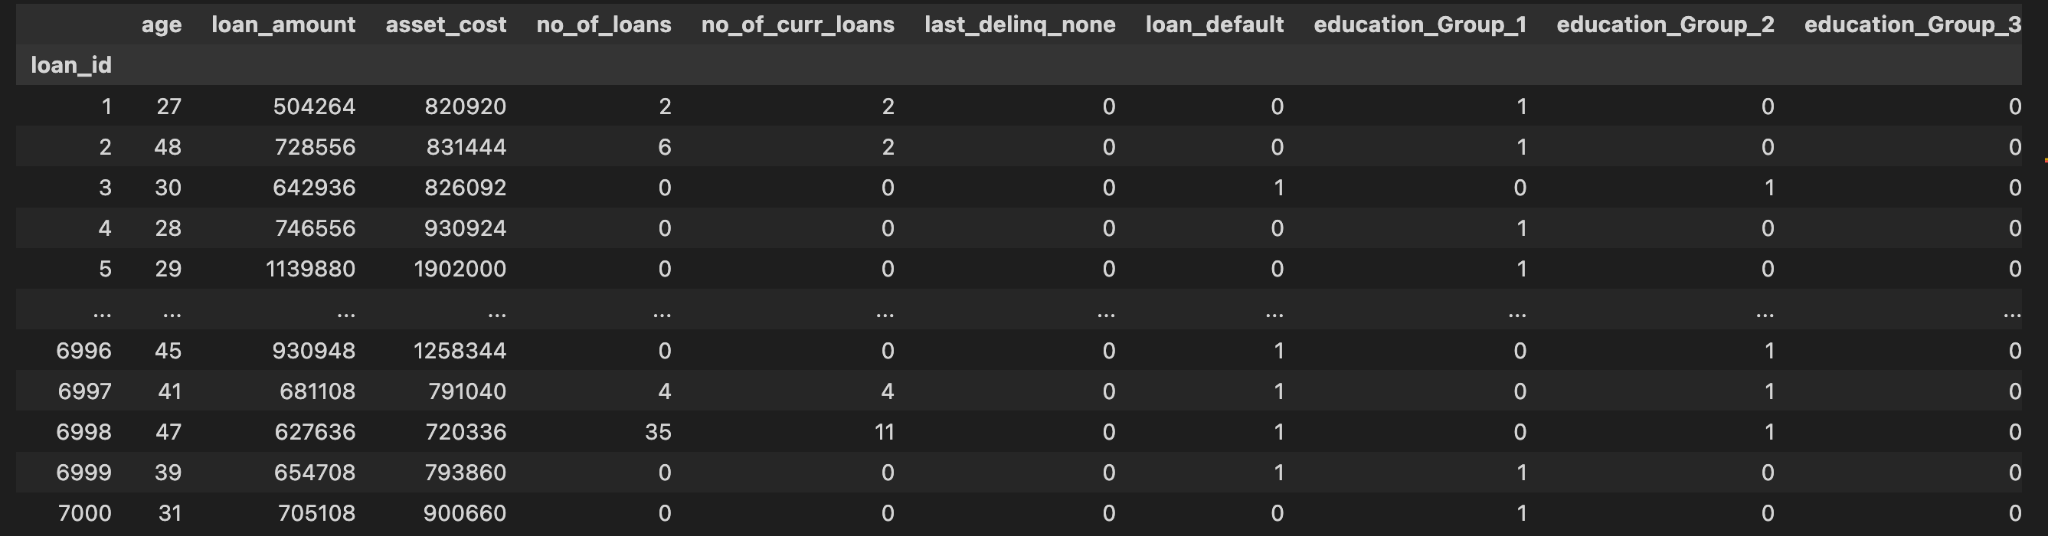
3. 데이터 모델링
이제 드디어 데이터를 모델링할 차례에요. 이를 위해 다음 두 가지 도구를 선택해야 하죠.
- 사용할 모델/알고리즘
- A 사용하다
모델은 기본적으로 컴퓨터가 예측을 수행하는 방법을 알려주는 수학적 알고리즘이에요. 에이모델의 예측 성능을 판단하는 방법이고요.
어떤 모델을 선택해야 하는지 알아보려면 Sklearn 사용자 가이드를 참조하세요. 여기서 다루기에는 너무 많기 때문에 다양한 모델에 대한 개요를 살펴보세요. 하지만 모델을 선택할 때 고려해야 할 몇 가지 비교 사항은 다음과 같아요.
- 설명 가능성/해석 가능성
- 과적합/과소적합 경향
점수 함수는 우선순위가 달라요. 거짓 음성, 거짓 양성 또는 이 둘의 혼합을 최소화하는 데 우선순위를 둘 수 있죠. 특정 사례에서 위양성(false positive) 또는 위음성(false negative)이 더 큰 피해를 주는지 확인하세요. 예를 들어, 의료 분야에서 질병 진단의 거짓 음성은 치명적일 수 있지만, 거짓 양성은 일반적으로 생명을 위협하지 않아요. 다양한 점수 기능을 살펴보고 싶다면, Wikipedia의 "Confusion Matrix" 기사가 훌륭한 자료가 될 거에요.
모델은 부울 값(차용인의 채무 불이행 여부)을 예측하므로 분류 모델을 사용하는 것이 좋겠죠? 우리는 과소적합과 과적합 모두에 빠르고 강력하기 때문에 Random Forest 모델을 선택할 거예요.
점수 함수의 경우 회사가 위험을 회피하고 거짓 부정(즉, 모델이 차용인이 채무 불이행을 하지 않을 것이라고 예측하는 경우)을 최소화하기를 원한다고 가정해 볼게요. 그만큼점수 함수는 이 목표를 포착해요. 이는 다음과 같이 정의되죠.
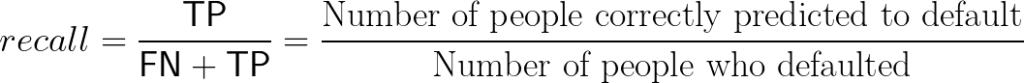
모델과 점수 함수를 선택하면 이제 실제로 모델 코딩을 시작할 수 있어요. 먼저, scikit-learn의 `train_test_split` 함수를 사용하여 데이터를 '훈련' 데이터와 '테스트' 데이터로 분할합니다. 모델을 제공했다면 이 작업을 수행하는 것이 중요해요.all데이터의 경우 예측을 위해 데이터를 그대로 반복하거든요.
from sklearn.model_selection import train_test_split


X_train, X_test, y_train, y_test = train_test_split(
   data.drop(["loan_default"], axis=1),
   data["loan_default"],
   test_size=0.4,
)
첫 번째 인수는 예측 변수("독립 변수")로 사용할 컬럼을 제공하고, 두 번째는 대상 컬럼을 제공해요. test_size 매개변수는 테스트용으로 예약할 데이터의 양을 결정하는데, '0.4'에서 '0.6' 사이의 값은 일반적으로 좋은 선택이라고 여겨져요.
다음으로 모델과 점수 함수를 가져와 볼게요.
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import recall_score
대부분의 모델에는 모델을 다양하게 변형하기 위해 조정할 수 있는 "하이퍼파라미터"가 있죠. GridSearchCV 클래스는 여러 하이퍼파라미터 세트를 테스트하고 가장 적합한 파라미터를 선택하는 방법을 제공해줘요.
from sklearn.model_selection import GridSearchCV


clf = GridSearchCV(
   RandomForestClassifier(),
   {
       "criterion": ["gini", "entropy"],
       "max_depth": [50 + i * 10 for i in range(10)],
       "oob_score": [True, False],
       "max_features": ["sqrt", None, 6],
       "min_impurity_decrease": [0.00, 0.001],
       "class_weight": ["balanced"],
   },
   scoring="recall",
   n_jobs=-1,
   verbose=3,
)
확인해보시면 좋아요. scikit-learn 문서에서 이러한 하이퍼파라미터의 기능에 대한 설명을 찾을 수 있을 거예요. 목표 값이 채무 불이행을 한 사람과 그렇지 않은 사람 사이에 균등하게 분배되지 않았기 때문에 'class_weight'는 'balanced'로 설정되었어요.
clf.fit(X_train, y_train)

Fitting 5 folds for each of 240 candidates, totalling 1200 fits
[CV 2/5] END class_weight=balanced, criterion=gini, max_depth=50, max_features=sqrt, min_impurity_decrease=0.0, oob_score=False;, score=0.297 total time=   0.7s
[CV 3/5] END class_weight=balanced, criterion=gini, max_depth=50, max_features=sqrt, min_impurity_decrease=0.0, oob_score=False;, score=0.373 total time=   0.7s
[CV 1/5] END class_weight=balanced, criterion=gini, max_depth=50, max_features=sqrt, min_impurity_decrease=0.0, oob_score=False;, score=0.376 total time=   0.7s
[CV 5/5] END class_weight=balanced, criterion=gini, max_depth=50, max_features=sqrt, min_impurity_decrease=0.0, oob_score=True;, score=0.307 total time=   0.8s
…
검색 중에 찾은 최상의 모델의 점수와 파라미터를 출력하려면 다음 코드를 사용하면 돼요.
print(
   "Recall score of best model:",
   round(recall_score(y_test, clf.predict(X_test)) * 100, 2),
   "%",
)
print("Best model parameters:")
clf.best_params_

Recall score of best model: 56.72 %
Best model parameters:
{'class_weight': 'balanced',
 'criterion': 'gini',
 'max_depth': 70,
 'max_features': 6,
 'min_impurity_decrease': 0.001,
 'oob_score': True}
우리의 Recall 점수에 따르면, 결국 채무 불이행으로 끝난 대출자 중 56%를 모델이 정확하게 식별했는데, 꽤 괜찮은 결과죠!
Neo4j에서 예측 모델링 시작하기
이번 글에서는 Kaggle의 데이터 세트를 사용해서 예측 모델을 구축하는 방법을 알아봤어요. 이 데이터 세트는 처음부터 비교적 깨끗했지만, 실제로는 데이터베이스에서 데이터를 `Query`하고, `Query`를 마친 후에도 구성을 수행해야 할 거예요. Python에서 데이터베이스에 연결하는 방법도 알아두면 좋겠죠.
Neo4j의 Graph Data Science와 같은 분석 및 Machine Learning 엔진은 데이터의 관계를 사용해서 데이터를 쉽게 `Query`하고 구성해서 예측을 향상시키는 데 도움을 줘요. 엔터프라이즈 데이터 에코시스템에 직접 연결되므로 더 많은 데이터 과학 프로젝트를 빠르고 효율적으로 프로덕션에 투입할 수 있어요. 다른 블로그 게시물도 확인해서 Neo4j Graph Data Science를 사용해서 Python에서 Machine Learning 모델을 개선하는 방법을 알아보세요.
기본 Python 클라이언트와 직관적인 Graph Data Science API를 사용하면 예측 모델 생성을 시작하기 위해 복잡한 설정이 필요하지 않아요. 사전 구성된 그래프 알고리즘 및 자동화된 절차에 대한 액세스와 결합되어 조직이 데이터를 실행 가능한 통찰력으로 빠르게 전환할 수 있다는 의미이기도 하고요.
또한 Neo4j Graph Data Science는 자동화된 MLOps 서비스를 제공하는 동시에 Apache Arrow, KNIME 및 Dataiku와 같은 인기 있는 플랫폼과 직접 통합돼요. 예측 모델을 재사용, 공유 및 수정할 수 있는 빠르고 쉬운 방법이어서 현재 기술 스택에 관계없이 Neo4j를 팀의 워크플로우에 쉽게 통합할 수 있죠.
Neo4j Graph Data Science로 지금 바로 Python을 사용해서 Machine Learning 및 예측 모델링 기능을 향상시켜 보세요.
- Graph Data Science
- Machine Learning
- Python
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| Building a Neo4j Graph Agent for Gemini Enterprise (1) | 2026.10.04 |
|---|---|
| GRANDstack으로 GraphQL 기반 CMS 구축하기 (0) | 2026.10.04 |
| Python으로 예측 모델 구축하는 궁극 가이드 (0) | 2026.10.04 |
| $250 기프트 카드 획득 기회! AuraDB 베타로 GraphQL과 함께 Conway's Game of Life 구축하기 (0) | 2026.10.04 |
| GraphQL로 r/place 클론을 만든 방법 (0) | 2026.10.03 |