
소셜 네트워크는 Graph Database로 가져와서 탐색하기 정말 좋기 때문에 제가 이번 주에 이 작업을 했어요. 스트리밍 녹화 영상을 보고 싶다면 아래에서 확인하세요. 아니면 이 블로그에서 자세한 내용을 알려드릴게요.
Bluesky는 소셜 미디어 애플리케이션으로, Authenticated Transfer Protocol (ATP)를 사용하고 있고, 요즘 엄청난 관심을 받고 있어요. 대기자 명단에 거의 200만 명이 있고 현재 사용자 수는 65,000명 정도이며, 지금까지 게시물은 대략 200만 개 정도 된다고 해요.
많은 유명인, 언론인, 기술 전문가들이 이미 활동하고 있지만, 특히 BIPOC, 게이, 트랜스젠더와 같이 일반적으로 과소 대표되는 소수자 출신의 사람들이 더 많이 활동하고 있다는 점이 눈에 띄어요.
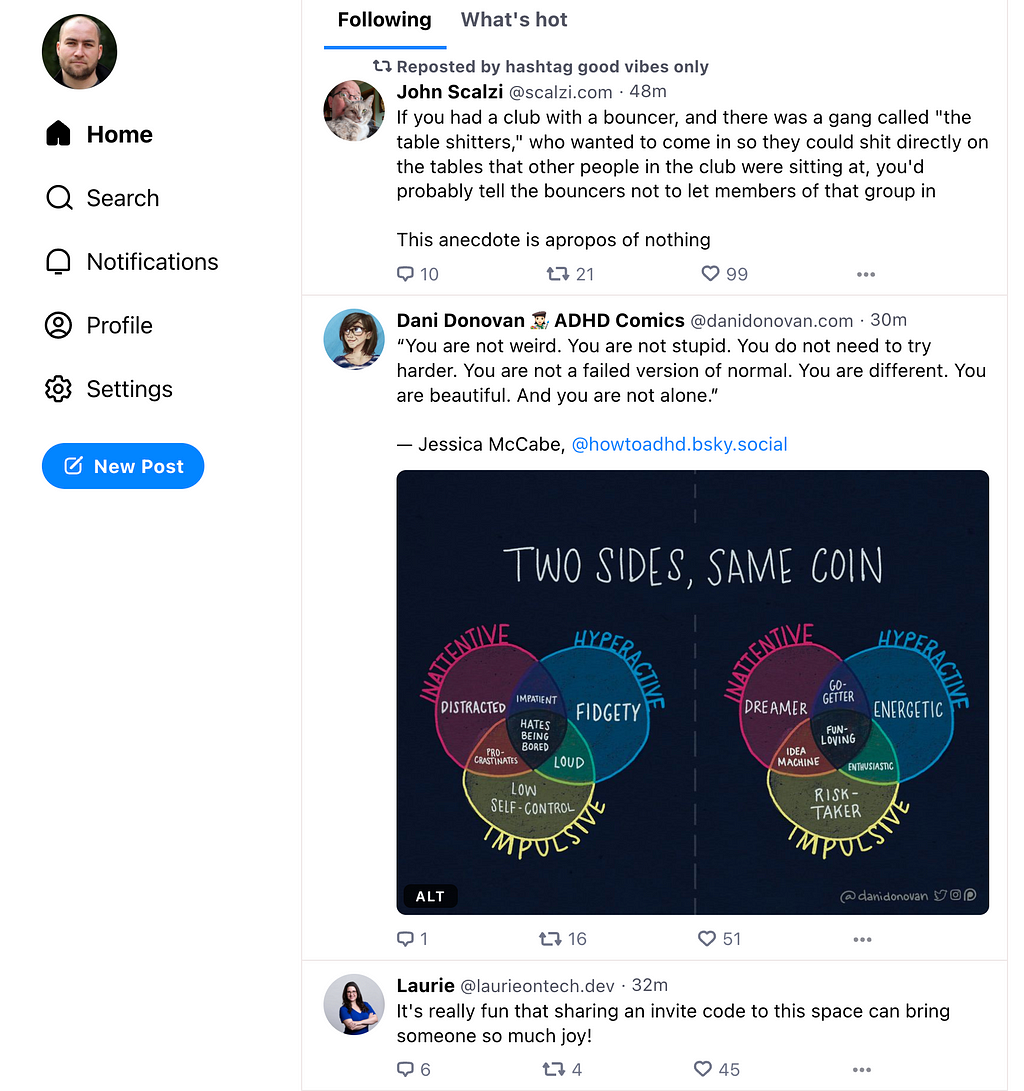
Bluesky는 지금 2007년 초기의 트위터처럼 느껴져요. 많은 재미와 농담이 있고, 모두가 간단한 이야기를 공유하는 것만으로도 편안함을 느끼는 분위기죠. Jake Tapper, AOC (AMA도 했어요!), James Gunn에게 핑을 보내고 실제로 답변을 받을 수 있다는 건 정말 새롭고 멋진 경험이에요.
지금까지 괴롭힘이나 나쁜 행동은 본 적이 없지만 (제 버블 안에만 있어서 그럴 수도 있어요), 다양한 관점에서 확장 가능한 조정 및 사용자 보호에 대한 많은 이야기가 오가고 있어요.
앱 자체는 정말 최소한의 기능만 제공하지만, 이전보다 더 큰 규모로 프로토콜을 테스트하기 위한 레퍼런스 구현을 제공하기 위한 목적도 있어요. 확장은 느린 속도로 진행되고 있고, 대부분의 사용자는 몇 가지 예외를 제외하고 2주마다 초대 코드 1개를 받게 돼요.
The AT 프로토콜은 사용자를 식별하기 위해 모든 것을 분산 ID (DID)에 기반한다는 점에서 정말 흥미로워요. 데이터 (게시물, 좋아요, 미디어)는 통합 '개인 데이터 서버' (PDS)가 호스팅하는 저장소에 암호화 방식으로 서명되어 저장되죠.
프로토콜 개요 | AT 프로토콜
AT 프로토콜을 사용하면 사용자는 자신의 도메인을 사용하여 `_atproto` DSN record를 통해 자신이 누구인지 (예: washingtonpost.com) 공식적으로 선언할 수 있어요.
DNS에서 직접 기록을 가져온 다음 자리 표시자 서비스 (PLC)에 쿼리하여 해당 ID에 대한 자세한 내용을 확인할 수 있어요. 제 경우에는 저장소 데이터 서버 (PDS)와 별칭으로 제 도메인을 볼 수 있죠.
dig TXT _atproto.mesirii.de

; <<>> DiG 9.10.6 <<>> TXT _atproto.mesirii.de
...
;; ANSWER SECTION:
_atproto.mesirii.de.	3276	IN	TXT	"did=did:plc:gteyzzitmjhuezvsi6nyrszj"


curl -s  | jq .
{
  "did": "did:plc:gteyzzitmjhuezvsi6nyrszj",
  "verificationMethods": {
    "atproto": "did:key:zQ3shXjHeiBuRCKmM36cuYnm7YEMzhGnCmCyW92sRJ9pribSF"
  },
  "rotationKeys": [
    "did:key:zQ3shhCGUqDKjStzuDxPkTxN6ujddP4RkEKJJouJGRRkaLGbg",
    "did:key:zQ3shpKnbdPx3g3CmPf5cRVTPe1HtSwVn5ish3wSnDPQCbLJK"
  ],
  "alsoKnownAs": [
    "at://mesirii.de"
  ],
  "services": {
    "atproto_pds": {
      "type": "AtprotoPersonalDataServer",
      "endpoint": "https://bsky.social"
    }
  }
}
프로토콜 문서에 더 자세한 내용이 있어요. , Rust, Python, Javascript 등 다양한 언어를 사용할 수 있고, 벌써 약 1000명이 Bluesky-Dev-Discord에 참여하고 있대요. 이 프로토콜은 데이터의 정확한 해석을 보장하기 위해 'Lexicon' 기반의 스키마 접근 방식과 함께 통신을 위해 백그라운드에서 HTTPS 및 XRPC를 사용한답니다.
다음과 같은 대체 앱들(Graysky, Firesky, or Skypulse)이 이미 이 프로토콜을 사용하고 있고, 앞으로 더 많은 앱들이 나올 예정이에요.
플랫폼의 모든 게시물에 대한 Firehose를 얻는 한 가지 방법은 이벤트 리스너를 스트림에 등록한 다음, 새 게시물이 데이터 저장소에 추가될 때 "커밋 알림"을 받는 거예요. 이건 새로운 데이터에만 적용되고 과거 이벤트에는 적용되지 않죠.
Bluesky 사용자 Jaz 님이 Postgres 데이터베이스의 주요 게시물을 추적하고 수집할 뿐만 아니라, 이를 집계하고 시각화하는 시스템을 오랫동안 개발해 왔어요. Interaction Graph(현재 20,000명의 사용자와 140,000개의 연결로 630,000개의 상호 작용을 나타냄)는 정말 멋진 결과물이죠!
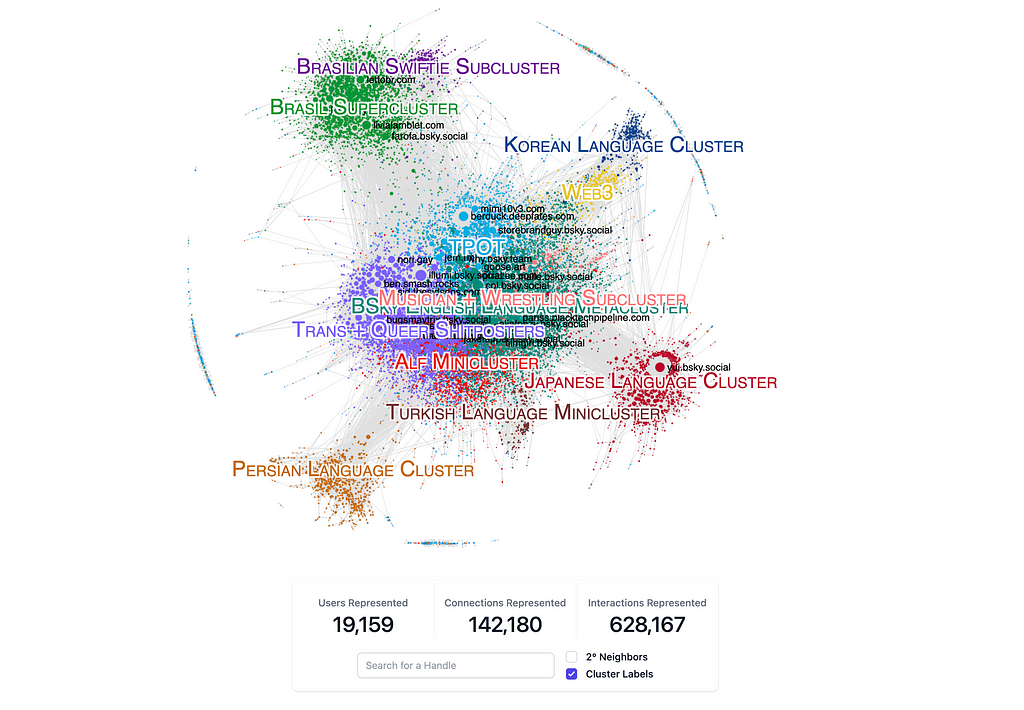
저는 지난 주 “ChatGPT로 코딩하기” 세션에서 제 주제를 더 깊이 파고들었어요. 코드를 자세히 살펴보고 API를 사용해 보고, 심지어 Neo4j를 약간 통합하기도 했답니다 (향후 추가 예정).
Interaction Graph (사용자 간 최소 2개의 대화)는 메모리에 보관되고, 클러스터링, 중심성 기반 크기 조정 및 사전 레이아웃을 위한 그래프 알고리즘을 사용하여 직렬화, 렌더링 및 개선될 수 있어요. Jaz 님은 Sigma.js를 사용해서 프론트엔드에서 이미 레이아웃된 그래프를 시각화하고, 자체 핸들 검색과 같은 상호 작용을 추가했죠.
하지만 오늘의 "그래프 세션 소개"에서는 내용이 너무 깊어졌네요.
여기서는 Jaz 님의 사전 계산된 데이터에서 Interaction Graph를 가져와서 Neo4j에서 시각화 및 쿼리하고, Jaz 님이 사전 계산을 위해 했던 것처럼 클러스터링 및 크기 조정을 위해 데이터에 대한 일부 그래프 알고리즘을 실행하려고 해요.
다행히 웹 시각화에 로드된 데이터는 그래프를 빠르게 구성할 수 있는 'node' 및 'edge' 항목이 포함된 JSON 파일로 제공돼요.
데이터에 그래프 알고리즘을 실행하기 위해 오늘은 AuraDS(Data Science)를 사용할 거예요. 이 서비스는 이러한 목적에 최적화되어 있고, graph-data-science 라이브러리가 설치되어 있거든요.
아니면 Neo4j Sandbox나 로컬에 설치된 Neo4j Desktop 또는 Docker를 사용해도 돼요.
최소 인스턴스 크기는 저희가 사용하기에는 다소 과하긴 해요. 1000배 더 많은 데이터를 쉽게 관리할 수 있지만, 사용 및 설정이 가장 쉽죠. 처음에는 Estimator를 사용해서 사용하려는 데이터 볼륨과 알고리즘을 제공하고 인스턴스 크기를 제공할 수 있어요.
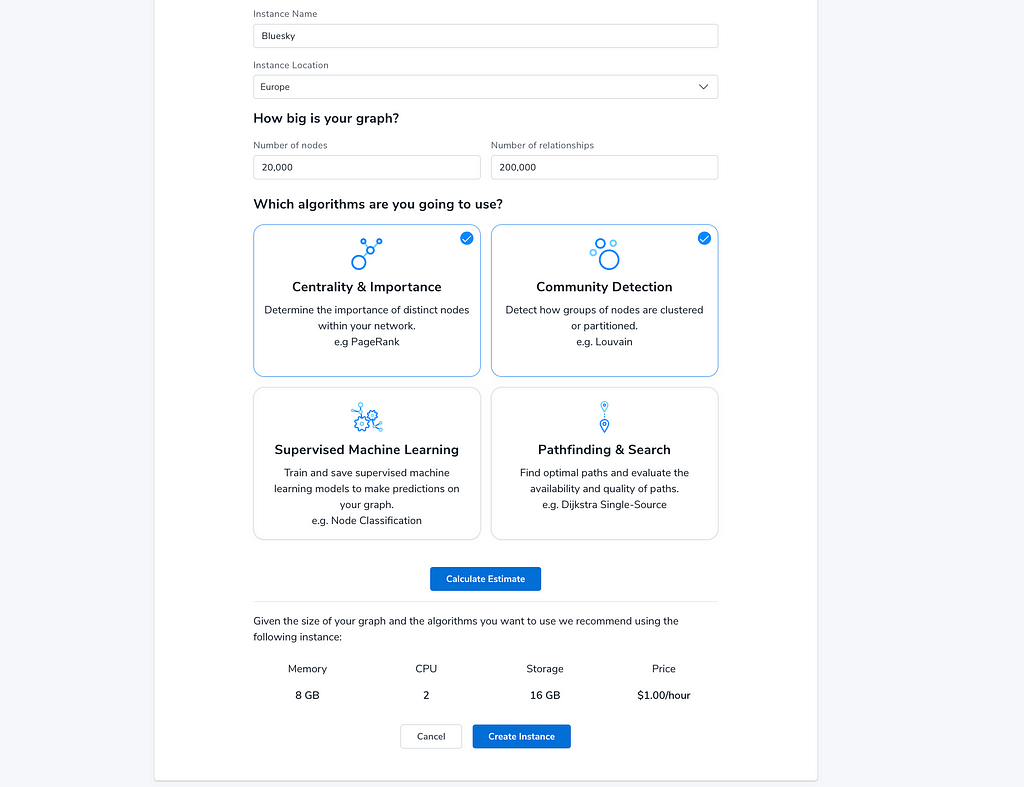
인스턴스를 생성하는 동안 데이터베이스 URI, 사용자 이름 및 비밀번호가 포함된 자격 증명 파일을 다운로드해야 해요.
데이터를 가져오려면 “[열기]” 버튼을 사용하여 “Neo4j Workspace”를 열고 비밀번호를 입력하세요.
그런 다음 'Query' 탭을 방문해서 빠른 가져오기를 시작할 수 있어요.
저희 데이터 모델은 정말 간단해요. Interaction Relationship으로 연결된 User Node가 있죠. 둘 다 JSON에서 직접 가져올 수 있는 다양한 속성(key, label(핸들), 크기, 무게, 색상, 커뮤니티, x,y)을 가지고 있어요.
먼저 고유성을 보장하고 key로 User를 빠르게 조회해서 연결할 수 있도록 User 및 key에 대한 Constraint를 만들어 볼게요.
create constraint user_key if not exists for (u:User) require (u.key) is unique;원래는 사용자 이름(데이터의 label이라고도 함)에 대한 Constraint도 만들었지만, 중복된 사용자가 있으므로 먼저 병합해야 해요. 하지만 이에 대해서는 나중에 자세히 설명할게요.
다음으로 파일의 일부 항목을 살펴보고 사용자 정의 프로시저인 apoc.load.json을 사용해서 파일과 JSON 경로 표현식을 로드하고 'nodes' 항목을 가져와 볼게요.
call apoc.load.json("https://bsky.jazco.dev/exported_graph_minified.json","$.nodes")
yield value as nv
return nv limit 5;
Cypher 구성을 통해 중첩된 맵(dict)과 목록(배열)으로 파일의 구조를 반환하는 것을 확인할 수 있어요.
{
  attributes: {
    area: 9.51,
    size: 3.48,
    color: "#7EC0EE",
    x: -824.56,
    y: -6222.31,
    label: "maxberger.bsky.social",
    community: 1,
    key: 1
  },
  key: "1"
}
보시다시피 `key`를 id로 사용해서 `User`를 생성하고 다른 속성들을 설정할 수 있겠죠? 바로 그걸 해볼 거예요.
메모: `MERGE`를 사용해서 작업을 멱등성(가져오기 또는 만들기)으로 만들어서 원하는 만큼 자주 다시 실행할 수 있도록 할 거예요. 그리고 10,000개 행의 배치를 사용하고 있는데, 20,000명의 사용자에게는 크게 중요하지 않지만 앞으로 수백만 명의 사용자를 생각하면 중요해져요.
또한 데이터 유형(문자열 vs 정수)이 다르기 때문에 속성을 `Node`에 추가하기 전에 속성에서 `key`를 제거할 거예요.
call apoc.load.json("https://bsky.jazco.dev/exported_graph_minified.json","$.nodes")
yield value as nv
call { with nv
   merge (n:User {key:nv.key})
   on create set n += apoc.map.clean(nv.attributes,["key"],[])
} in transactions of 10000 rows;
이렇게 하면 데이터베이스에 약 19,000개의 외로운 `Node`들이 생겨요.
속성에 따라 스타일을 지정하고 위치를 지정할 수 있지만, 관계가 없으면 너무 심심하겠죠? 😅
먼저 데이터를 살펴본 다음, 이걸 사용해서 다시 추가해 볼게요.
call apoc.load.json("https://bsky.jazco.dev/exported_graph_minified.json","$.edges") yield value as ev
return ev limit 5;
다음과 같은 결과가 반환될 거예요.
{
  attributes: {
    size: 0.2,
    weight: 2,
    ogWeight: 2
  },
  source: "723",
  key: "geid_35_0",
  target: "15220"
}
이제 각 edge에 대한 이 데이터를 사용해서 시작 및 끝 `Node`를 조회한 다음, 이를 `INTERACTS` 관계로 연결하고 관계에 대한 레코드의 속성을 설정할 수 있어요.
여기서 `MERGE` 작업은 양방향 상호 작용을 결합하므로 방향을 생략할게요.
call apoc.load.json("https://bsky.jazco.dev/exported_graph_minified.json","$.edges") yield value as ev
call { with ev
    match (source:User {key:ev.source}),(target:User {key:ev.target})
    merge (source)-[r:INTERACTED {key:ev.key}]-(target)
    set r += ev.attributes
} in transactions of 20000 rows;
이제 그래프의 데이터를 사용해서 탐색을 시작하고 탐색 탭으로 이동해서 따라갈 수 있어요.

제가 한 모든 일을 스크린샷으로 설명하는 대신 아래 스트림의 5분 부분(25:30부터)을 시청해 보시는 건 어때요?
현재 우리는 다음을 수행하고 있어요.
- 상호작용 그래프를 시각적으로 탐색해서 관계를 확장하고 추가 데이터를 로드했고,
- 커뮤니티, 크기 및 가중치 속성을 기반으로 스타일이 지정된 `Node` 및 관계,
- 그래프 알고리즘(클러스터의 경우 Louvain, 크기/중요도의 경우 PageRank)을 실행하고 그 결과를 스타일 지정에 사용했고,
- 강제 레이아웃뿐만 아니라 좌표 레이아웃을 사용해서 Jaz에서 미리 계산된 x,y 값을 사용해서 그래프를 자연스럽게 레이아웃했고,
- 필터링을 사용해서 가중치가 낮은 (2,3) 관계를 무시했어요.
Michael 및 Alexander와 함께 Neo4j AuraDB 무료 발견 – Bluesky 사용자 상호 작용 가져오기
최근에는 Jaz가 렌더링 작업을 하고 있는데, 특히 큰 스레드(게시물이 10,000개가 넘는 Hellthread처럼)를 시각적으로 보여주는 데 집중하고 있어요.
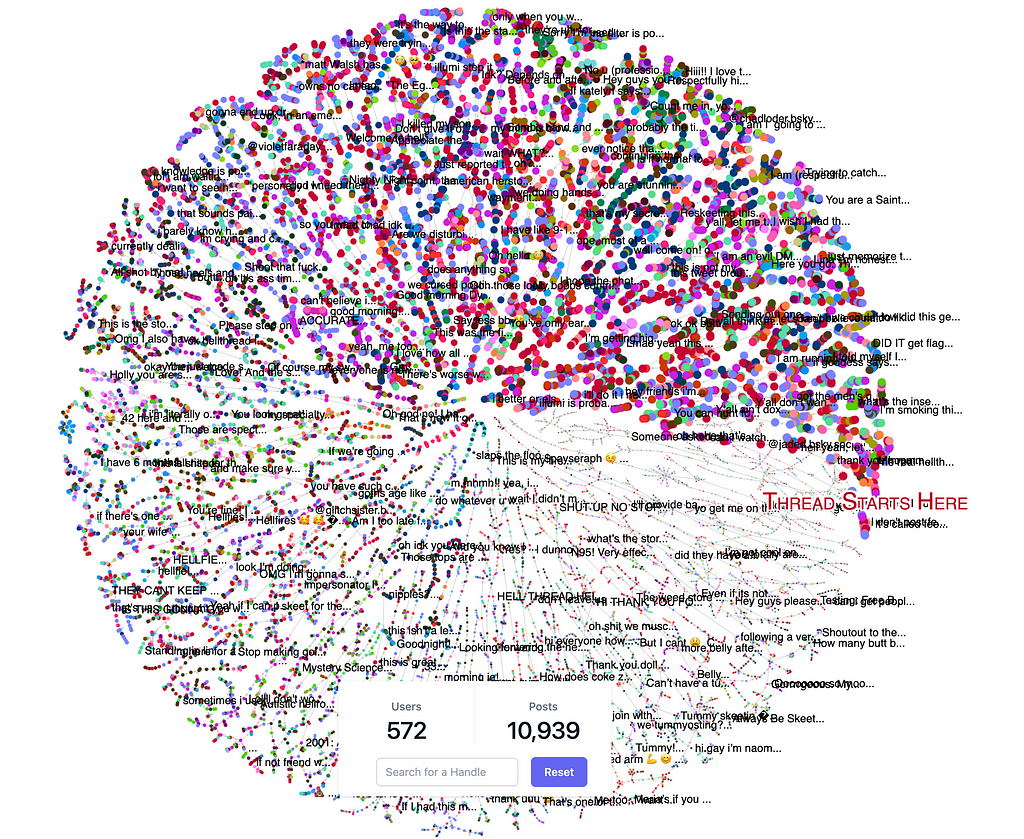
해당 스레드 시각화에는 게시물도 포함되어 있으므로 게시물도 가져오고 싶었어요.
그럼 데이터를 가져와서 간단히 살펴볼까요?
call apoc.load.json("https://bsky-search.jazco.io/thread?authorHandle=ihatenfts.hellthread.vet&postID=3jv6terdbop2z&layout=true","$") yield value as post
RETURN count(*);
// 10939

call apoc.load.json(https://bsky-search.jazco.io/thread?authorHandle=ihatenfts.hellthread.vet&postID=3jv6terdbop2z&layout=true","$") yield value as post
RETURN post limit 5;

{
  depth: 2,
  post: {
    root_post_id: "3juzlwllznd24",
    parent_relationship: null,
    author_did: "did:plc:pbxv2f7r5eo47e3ylwczhk32",
    has_embedded_media: false,
    parent_post_id: "3juzoytvr7s2y",
    created_at: "2023-05-05T19:35:36.601-07:00",
    id: "3juzp3fjlds26",
    text: "Were you supposed to tag someone?"
  },
  x: 1657.06,
  y: -344.76,
  author_handle: "kentbye.com"
}
여기서 우리는 작성자 핸들과 게시물 ID, 텍스트, Create_at, 그리고 내장된 미디어가 있는지 여부를 알 수 있어요. `parent_post_id`는 스레드의 이전 게시물(상위 관계는 항상 null)에 연결하고, `root_post_id`는 스레드를 시작한 게시물(상위 항목이 없는 게시물)에 대한 참조인거죠.
따라서 이걸 사용해서 다음과 같은 구조를 만들 수 있어요.
(:User {did, label/핸들})-[:POSTED]→(p:Post {id, 텍스트, 생성됨, 미디어, 루트})-[:PARENT]→(parent:Post)
하지만 먼저 이미 가져온 소스 데이터에서 중복된 Users를 수정해야 해요. 다행히 `label`(핸들)은 동일하지만 키가 다른 중복된 User는 단 한 명뿐이에요.
`label`별로 Users를 그룹화하고, 발생 횟수를 계산하고, 항목을 User 목록으로 수집할 수 있어요. 개수가 1보다 큰 모든 `label`의 경우 관계를 유지하면서 해당 `Node` 목록을 단일 `Node`로 병합하는 거죠.
여기 있는 우리 친구는 바로 그 일을 하는 `apoc.refactor.mergeNodes`에요.
match (u:User)
with u.label as label, count(*) as count, collect(u) as users
where count > 1
call apoc.refactor.mergeNodes(users) yield node
return node;
이제 해당 `Property`에 대한 `Constraint`를 만들 수 있으므로 User에게 `label`을 지정하고 Post에 연결해서 빠르게 Users를 찾을 수 있어요.
create constraint user_label if not exists for (u:User) require (u.label) is unique;이제 Hellthread를 가져오기 위해 import 문을 실행해 볼게요.
- Post를 스트림으로 로드
- 10,000개 거래 일괄 처리
- ID가 있는 Post 가져오기 또는 만들기
- 항목에서 `Property`(x,y,깊이) 설정
- `Property` 설정(루트, 미디어, Create_at, 텍스트)
- 상위 Post 가져오기 또는 만들기
- 상위 Post에 연결
- 작성자 User 가져오기 또는 만들기
call apoc.load.json("https://bsky-search.jazco.io/thread?authorHandle=ihatenfts.hellthread.vet&postID=3jv6terdbop2z&layout=true","$") yield value as entry
call { with entry
   with entry, entry.post as post
   merge (p:Post {id:post.id})
   set
     p += entry {.depth, .x, .y},
     p += post { .root_post_id, .has_embedded_media, created_at: datetime(post.created_at), .text}
   merge (parent:Post {id:post.parent_post_id})
   merge (p)-[:PARENT]->(parent)
   with *
   merge (u:User { label: entry.author_handle})
   set u.did = post.author_did
   merge (u)-[:POSTED]->(p)
} in transactions of 10000 rows;
// Created 10995 nodes, created 21878 relationships, set 98507 properties, added 10995 labels
이제 데이터베이스의 경로와 스레딩을 탐색할 수 있는 멋진 Post 하위 집합이 생겼어요.
기본 패턴(post:Post)-[:PARENT]→(parent:Post)에 별표를 추가해서 가변 길이 패턴으로 확장할 수 있어요. 50개 홉에 대해 다음과 같아요. (post:Post)-[:PARENT*50]→(parent:Post)
따라서 해당 단일 경로 또는 몇 가지 경로를 가져오면 멋진 긴 체인(또는 트리)을 얻게 되는 거죠.
MATCH path = (post:Post)-[:PARENT*50]->(parent:Post)
RETURN path LIMIT 50
하지만 "탐색"은 계층적 레이아웃 또는 미리 계산된 스레드 시각화의 좌표 레이아웃을 사용하는 것이 훨씬 좋아요. 또한 WebGL 기반 레이아웃 및 렌더링은 `Query`의 d3 레이아웃보다 더 잘 확장될 거예요.
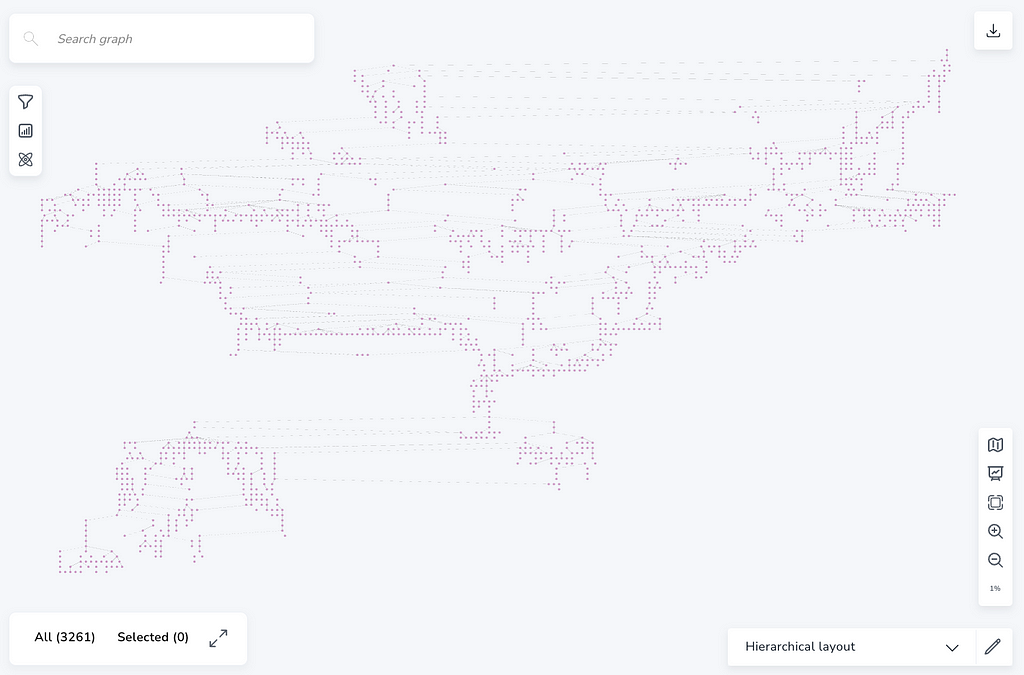
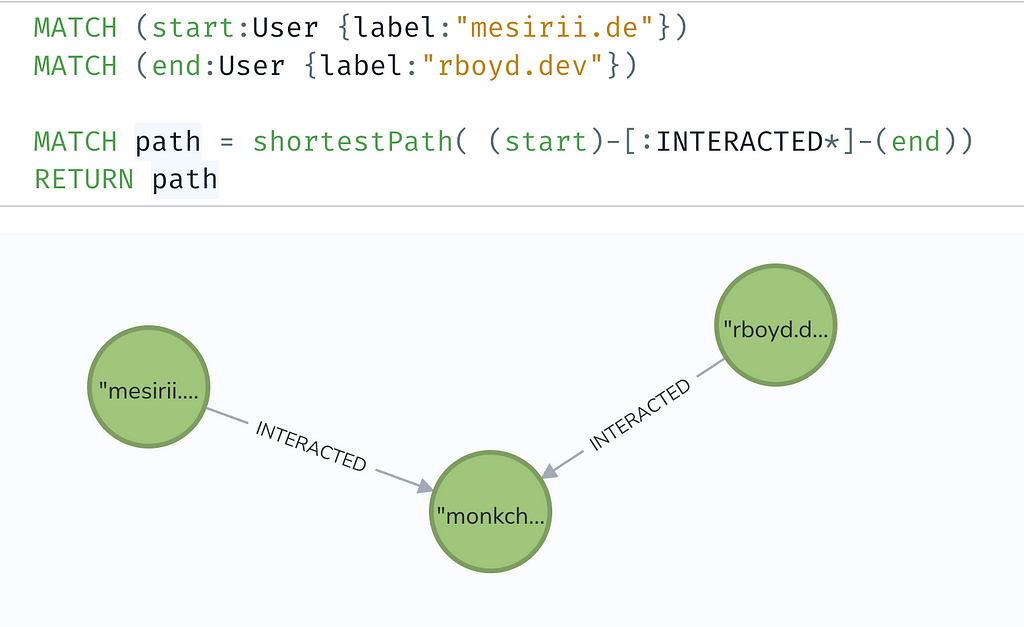
이제 User 간의 최단 경로를 찾을 수 있어요. 상호 작용 네트워크를 통해 또는 스레드의 Post를 통해 탐색의 상황에 맞는 메뉴에서 시각적으로 또는 다음 명령문을 통해 말이죠.
MATCH (start:User {label:"mesirii.de"})
MATCH (end:User {label:"rboyd.dev"})
MATCH path = shortestPath( (start)-[:INTERACTED*]-(end))
RETURN path
보시다시피 제 친구 Ryan과 저도 중재할 James Governor가 필요하네요 🙂
오늘 사용한 코드는 GitHub gist에서 찾을 수 있어요.
즐거운 사교 활동과 그래프 작성! 친절하게 대해주세요.
다음으로 작성하고 싶은 건 Postgres에서 캡처된 Bluesky 데이터를 사용하는 방법이에요. zhuowei님이 사용자, 게시물, 좋아요 및 팔로우 그래프를 Neo4j로 가져오는 방법을 다룰 거예요. 이미 CSV 덤프를 가져왔거든요. 하지만 그건 다음 블로그 게시물에서 다룰 내용이에요 🙂
- Bluesky
- Cloud
- 데이터 가져오기 및 내보내기
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| 세컨더리로 AuraDB 읽기 성능 확 끌어올리기 (0) | 2026.09.30 |
|---|---|
| “Boost” the power of your AI agents: Integrating Neo4j MCP with Laravel (0) | 2026.09.30 |
| Bluesky 사용자 상호작용 그래프: AuraDB Free로 발견하기 (47주차) (0) | 2026.09.30 |
| Bloom Scene Actions - 그래프와 상호작용하는 색다른 방법 (0) | 2026.09.30 |
| BloodHound: 그래프는 해커의 공격 방식을 어떻게 바꿨나 (0) | 2026.09.30 |