
방대한 그래프 데이터를 이해하려면 두 가지가 필요해요. Graph Database와 강력한 그래프 시각화 엔진이죠. 그래서 수백 명의 개발자가 Neo4j와 함께 KeyLines 그래프 시각화 툴킷으로 그래프 데이터를 탐색하고 이해하기 위한 효과적인 대화형 도구를 만들고 있답니다.
하지만 사람은 빅 데이터에 최적화된 존재는 아니에요. 대부분의 성인은 단기 기억에 4~7개 정도의 항목만 저장할 수 있다는 점을 고려하면, 엄청나게 많은 양의 촘촘하게 연결된 항목을 차트에 로드하는 건 오히려 통찰력을 얻는 데 방해가 될 수 있어요.
이 점이 바로 그래프 분석 도구를 구축하는 사람들에게 어려운 과제이죠.
사용자에게 어떤 데이터 하위 집합을 보여줘야 할까요? 가장 중요한 패턴과 연관성은 어떻게 찾아낼 수 있을까요?
이번 블로그 포스팅에서는 바로 이 내용을 살펴볼 거예요. 사려 깊은 계획을 세운다면 빅 데이터가 더 이상 큰 문제가 되지 않을 거라는 걸 알게 될 거예요!
대형 그래프 시각화의 과제
많은 조직에서 "빅 데이터"는 사용 가능한 모든 정보를 수집한 다음, 나중에 이를 사용하는 방법을 알아내는 것을 의미하죠. 이런 접근 방식의 문제점 중 하나는 개별 요소를 이해하기 위해 집계 분석을 넘어가는 게 엄청나게 어렵다는 거예요.
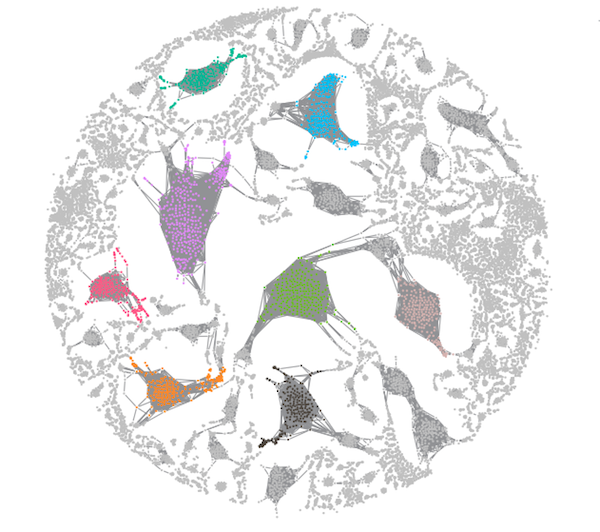
KeyLines에 시각화된 20,000개의 Nodes. 예쁘긴 하지만 특정 Node 동작을 이해하려는 경우엔 꽤 쓸모가 없을 수 있어요. 데이터 출처는 코스믹 웹 프로젝트입니다.
사용자에게 더 유용한 정보를 제공하려면 에 대해 생각해봐야 해요. 백엔드 데이터 관리와 프런트엔드 상호 작용의 다양한 단계를 거치면서, 이 퍼널은 수십억 개의 데이터 포인트를 사용자가 이해할 수 있는 정보로 줄여주죠.

빅데이터를 인간 규모로 축소하는 데이터 유입 경로!
퍼널의 각 단계에서 적용할 주요 기술에 대해 집중적으로 알아볼게요.
1. Neo4j에서 필터링: ~1,000,000개 이상의 Nodes
전체 Neo4j 인스턴스를 시각화하는 건 별 의미가 없겠죠. 가능한 한 빨리, 최대한 많은 노이즈를 제거해야 해요. Cypher 쿼리는 이걸 수행하는 아주 효과적인 방법이에요.
KeyLines와 Cypher의 통합은 사용자에게 슬라이더, 체크박스, 또는 사례 목록에서 선택하는 것과 같은 사용자 정의 필터링 쿼리를 생성할 수 있는 멋진 시각적 방법을 제공한다는 의미랍니다.
아래 예에서는 KeyLines에서 "검색 및 확장" 상호 작용을 지원하기 위해 Cypher 쿼리를 사용하고 있어요.
MATCH (movie:Movie{title: $name})<-[rel]-(actor:Actor)

RETURN *, { id: actor.id, degree: size((actor:Actor) --> (:Movie)) } as degree
먼저, KeyLines 차트에 추가하기 위해 반환하기 전에 선택한 영화와 관련된 배우를 매칭시키죠.

검색을 통한 필터링이 데이터 포인트를 관리 가능한 수준으로 유지하기에 충분하다는 보장은 없어요. 여러 번 검색하면 분석하기 어려운 과도한 양의 정보가 반환될 수 있거든요.
필터링은 효과적이지만, 이것만이 유일한 기술이 되어서는 안 돼요.
2. Neo4j에서 집계: ~100,000개 Nodes
필터링 기술이 확립되면 집계를 고려해야 해요. 이에 접근하는 방법은 두 가지가 있어요.
첫째, 중복과 오류를 제거하기 위한 데이터 정제가 있죠. 이건 종종 시간이 많이 걸리는 일이지만, Cypher는 여러분의 든든한 지원군이 될 거예요. "count"와 같은 Cypher 함수를 사용하면 백엔드에서 Nodes를 집계하는 게 정말 쉬워지거든요.
MATCH (e1:Employee)-[m:MAILS]->(e2:Employee)
RETURN e1 AS sender, e2 AS receiver, count(m) AS sent_emails
둘째, 애초에 KeyLines 차트에 진입하는 데 불필요한 요소를 제거하기 위한 데이터 모델링 단계가 있어요.
정리와 관련해서 물어볼 질문: 여러 Nodes를 병합할 수 있을까요? 여러 Links를 하나로 축소할 수 있을까요?
이 문제를 해결하는 데 시간을 투자할 가치가 충분히 있어요. 몇 가지 간단한 집계 결정만으로도 수만 개의 Nodes를 수백 개로 줄이는 게 가능하답니다.

링크 집계를 사용해서 22,000개의 nodes와 links를 훨씬 더 관리하기 쉽게 차트로 줄였어요.
3. 기발한 시각적 모델 만들기: ~10,000 – 1,000개 nodes
지금까지 Neo4j는 이미 1,000,000개 이상의 nodes를 수백 개로 줄이는 데 도움을 줬을 거예요. 데이터 시각화의 힘이 정말 빛을 발하는 곳이 바로 여기죠. 사용자의 시각화는 데이터베이스에 있는 내용 중 작은 부분에 의존하지만, 시각적 모델링을 사용해서 이를 더욱 단순화할 수 있어요.
아래 차트는 자동차 보험 청구와 관련된 그래프 데이터를 보여줘요. Neo4j 데이터베이스에는 자동차 및 보험 계약자, 전화번호, 보험 청구, 청구인, 제3자, 차고 및 사고가 포함돼 있죠.

전체 데이터 모델을 로드하는 것도 유용하지만, 신중하게 리모델링을 거치면 사용자는 필요한 통찰력에 적합한 대체 접근 방식을 선택할 수 있어요.
아마도 그들은 보험 계약자와 차고 사이의 직접적인 연결을 보고 싶어할 수도 있겠죠.
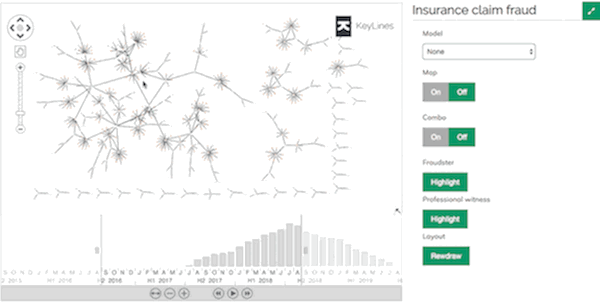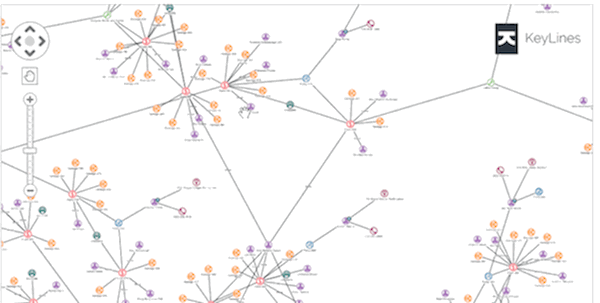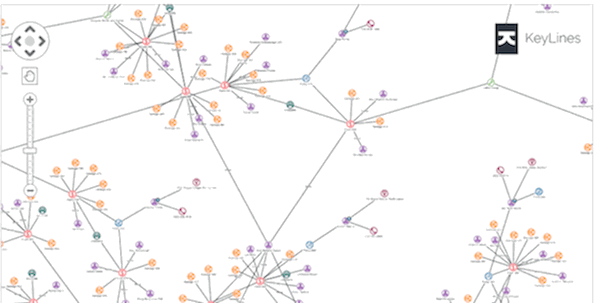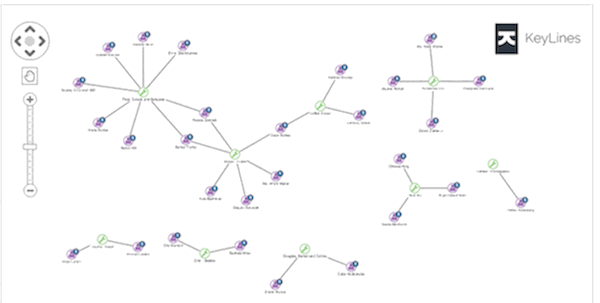
또는 사용자는 불필요한 중간 nodes를 제거하고 관련된 사람들 간의 연결을 보여주는 보기를 원할 수도 있고요.

이상적인 시각적 데이터 모델은 사용자가 대답하려는 질문에 따라 달라져요.
4. 필터, 결합 및 정리: ~1,000개 nodes
이제 사용자 차트에 관련 nodes와 links가 있으니, 정리하고 통찰력에 집중할 수 있는 도구를 제공해야 해요.
이를 수행하는 가장 좋은 방법은 요청 시 데이터의 하위 집합을 추가하거나 제거해서 필터링하는 거예요. 더 나은 성능을 위해 먼저 필터링된 보기를 제공하되, 데이터를 가져올 수 있는 사용자 제어 옵션을 제공하세요. 이를 수행하는 방법에는 체크박스, 슬라이더,타임바또는 “확장 및 로드”가 있죠.
또 다른 옵션은 KeyLines의 콤보 기능이에요. 콤보를 사용하면 사용자는 특정 nodes를 그룹화해서 차트에서 실제로 아무것도 제거하지 않고도 대규모 데이터 세트를 더 명확하게 볼 수 있어요. 이는 복잡성을 단순화하는 효과적인 방법일 뿐만 아니라, 그래프 통찰력을 더 쉽게 찾을 수 있도록 하는 "요청 시 세부 정보" 사용자 경험을 제공하죠.
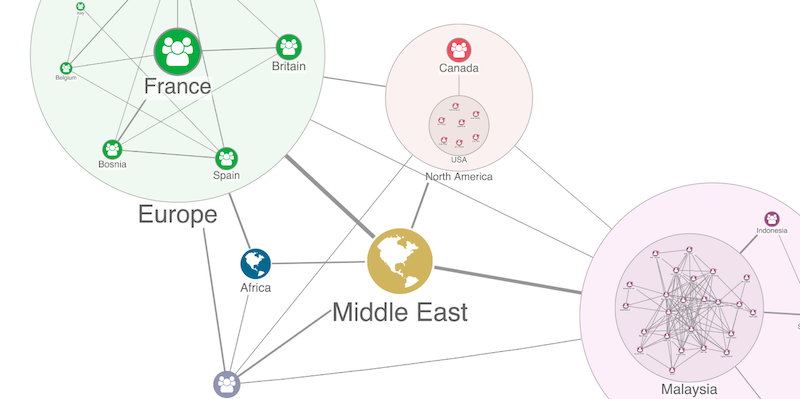
콤보는 차트의 혼란을 없애고 복잡성을 명확하게 해준대요.
모범 사례를 깔끔하게 정리하는 세 번째 예는 차트에서 불필요한 방해 요소를 제거하는 것이에요. 사용자에게 리프 `Node`를 "가지치기"하는 방법을 제공하거나, 차트를 어지럽히고 통찰력을 모호하게 만드는 "슈퍼 `Node`"를 쉽게 숨길 수 있게 만드는 것을 의미할 수 있죠.
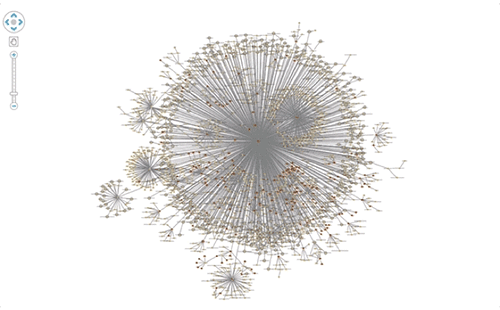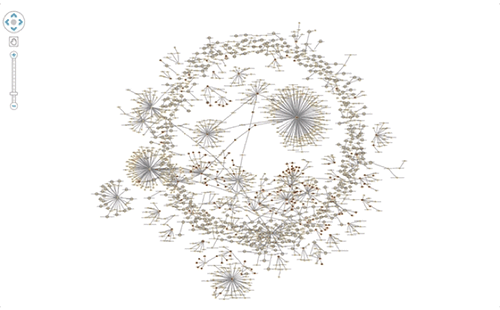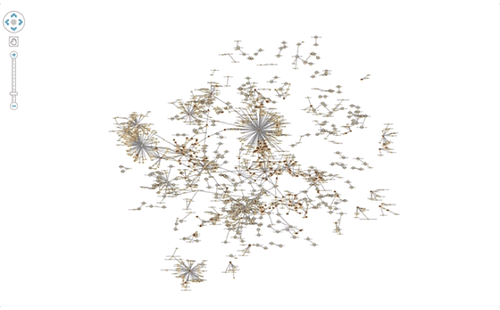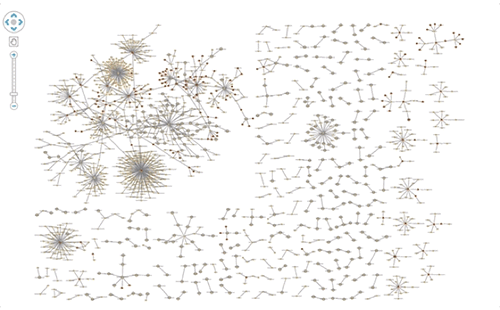
리프, 고아 및 슈퍼 `Node`는 그래프 데이터 이해에 거의 도움이 안 되니까, 사용자가 이를 제거할 수 있는 쉬운 방법을 제공해 주세요.
KeyLines는 그래프 데이터 분석의 중요한 부분을 지원하는 다양한 도구를 제공하고 있어요. 차트 혼란 관리에 대한 이 비디오에서 몇 가지 더 자세히 설명해 준답니다.
5. 레이아웃 실행: ~100개 `Node`
좋은 힘 방향 레이아웃은 단순히 링크를 풀어주는 것 이상이에요. 사용자가 원하는 답변을 찾을 수 있도록 안내하는 패턴, 이상 징후 및 클러스터를 확인하는 데도 도움이 되죠.
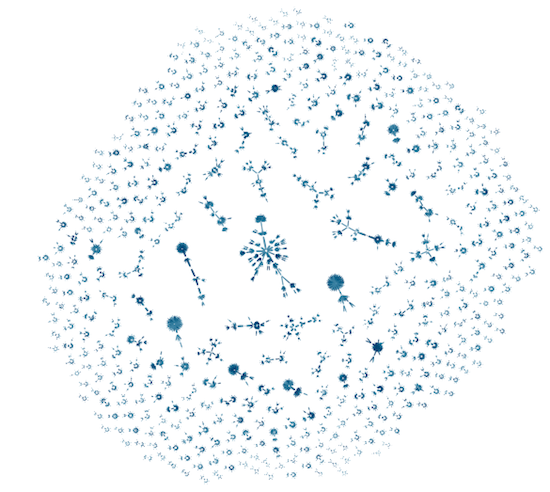
KeyLines의 최신 레이아웃 – 유기적 레이아웃! 특유의 부채꼴 패턴으로 `Node`와 링크를 펼치면 기본 구조가 훨씬 더 명확해진대요.
효과적이고 일관되며 강력한 그래프 레이아웃을 통해 사용자는 답변이 차트에서 튀어나오기 시작한다는 것을 알게 될 거예요.
보너스 팁: 사용자와 대화하세요
이 블로그 게시물은 사실 시작점일 뿐이에요. 빅 그래프 데이터 문제를 해결하는 데 도움이 되는 다른 팁과 기술이 많이 있답니다 (시간 분석이나 지리공간 시각화는 시작도 안 했는걸요!).
아마도 가장 중요한 팁은 이거 같아요. 사용자와 대화하는 시간을 가지세요.
그들이 확인해야 할 데이터와 대답하려는 질문이 무엇인지 알아보세요. 데이터 유입 경로를 사용하여 해당 프로세스를 가능한 한 간단하고 빠르게 만들고 Neo4j와 KeyLines의 결합된 기능을 사용하여 가장 큰 그래프 데이터 세트를 진정으로 통찰력 있는 것으로 바꿔보세요.
우리 웹사이트를 방문해서 그래프 시각화 모범 사례에 대해 자세히 알아보거나 KeyLines 툴킷을 시작해 보세요.
캠브리지 인텔리전스는 GraphConnect 2018의 골드 스폰서였대요.
에이치시스템즈의 LogTree는 Neo4j 기반 GraphRAG 플랫폼으로, 데이터를 자동으로 지식그래프화하고 자연어 질의로 즉시 답을 제공합니다.
'Neo4j' 카테고리의 다른 글
| GraphSummit에 가야 하는 7가지 이유 (0) | 2026.08.28 |
|---|---|
| [인포그래픽] 고객을 사로잡는 리테일의 6가지 관계 활용법 (1) | 2026.08.28 |
| 실시간 추천으로 사용자 혁신과 만족도를 5배 높이는 방법 (0) | 2026.08.27 |
| 그래프 데이터베이스로 밝혀낸 월드컵에 대한 5가지 놀라운 사실 (0) | 2026.08.27 |
| GraphConnect에서 주목해야 할 5가지 주요 토픽 (0) | 2026.08.27 |